27× tot 45× effectiever dan Claude en GPT: hoe een vloot van 23 fine-getunede AI-experts de markt domineert
Gepubliceerd op 11 May 2026
Wanneer je een LLM gebruikt voor dagelijkse softwareontwikkeling, loop je altijd tegen dezelfde muur aan: het model kent jouw codebase niet. Hij weet niet dat je zo’n patroon dehttps://fr.wikipedia.org/wiki/Graphe_orient%C3%A9_acyclique[DAG], dergelijke Gradle-conventie, dergelijke epistemische stratificatie in uwhttps://fr.wikipedia.org/wiki/AsciiDoc[.adoc]. Dan injecteren we hem met context, herhalen we, corrigeren we, itereren we. En de tijd — en het geld — gaan.
Ik heb dus de vraag direct gesteld: hoeveel zou een team van fine‑tuned modellen op mijn workspace kosten, dat code kan genereren in mijn stijl zonder dat het elke keer uitgelegd hoeft te worden? En vooral: hoe verhoudt deze aanpak zich tot de klassieke proprietairse oplossingen — Claude, GPT, Gemini, Grok?
Het antwoord verbaasde mij. Veel minder dan ik me had voorgesteld. En de kosten-effectiviteit-verhouding ten opzichte van de reuzen uit de sector is ongepast. Hier is het volledige detail.
Het probleem: waarom fine-tune en niet RAG?
RAG is goed. Mon knowledge graph en mon compartimentage épistémique werken. Maar RAG heeft een fundamenteel gebrek: bij elke vraag moet je de relevante context opnieuw injecteren. Je prompt wordt langer, je latentie explodeert, en het model intériorise nooit jouw patronen — het leest ze elke keer als een extern document.
De fine-tuning is spiergeheugen. Het model weet dat je schrijft`build.gradle.kts`met taken die zijn opgeslagen via`tasks.register`, dat jouw`AGENTS.adoc`volgen een gestandaardiseerde syntaxis, dat jouw werkruimte is gestructureerd in boroughs. Hij hoeft niet herinnerd te worden.
|
Fine-tuning is geen vervanging van RAG. Het is een aanvullende laag. RAG blijft relevant voor gegevens die vaak veranderen (logboeken, tickets, recente commits). Fine-tuning is voor structurele en stijlvol kennis op lange termijn. |
Het idee: een vloot van experts, geen enkel model
Een enkel gefinetuned model op mijn hele werkruimte is al goed. Maar het is suboptimaal. Mijn werkruimte bestrijkt zeer verschillende domeinen:
-
Gradle-plugins (Kotlin, conventie-plugins, samengestelde builds)
-
DAG-motor (Kotlin, planning, uitvoering)
-
LLM-agents (Python, LangChain4j, RAG)
-
Architecturale documentatie (AsciiDoc, bestuur)
-
Infra/DevOps (Docker, GitHub-acties, CI/CD)
Een uniek model zou overal goed moeten zijn, maar nergens uitblinken. De oplossing? Eenvloot van gespecialiseerde modellen, met een orchestrator die elke verzoek naar de goede expert routeert.
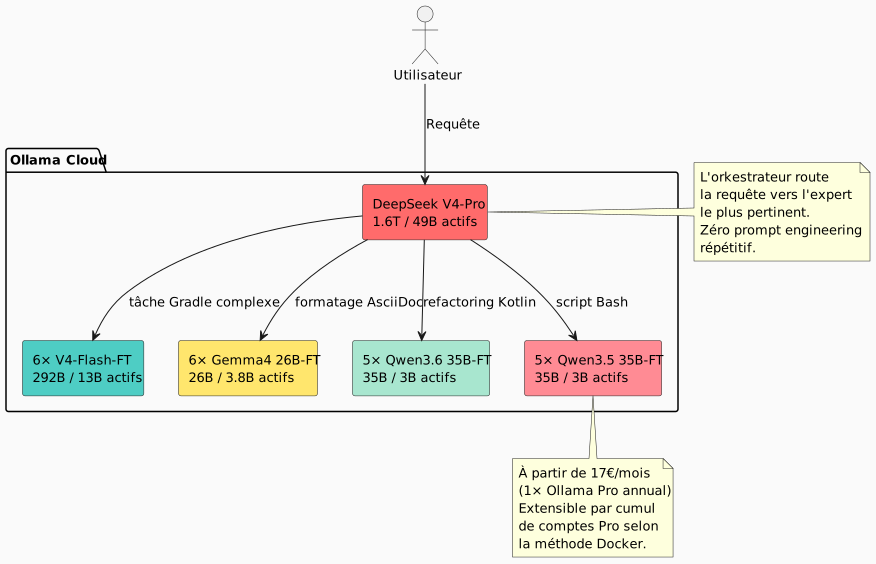
De totale vloot :1 orkestrator + 22 experts = 23 modellen. En wat is de maandelijkse inferentiekost?17€/maandOllama Pro abonnement jaarlijks — uitbreidbaar door accounts te stapelen als de quotas worden overschreden, zoals gedemonstreerd in mijn Docker multi-account methode. We beginnen bij 17€, we voegen 20€ toe per stap volgens de werkelijke behoefte. Geen verspilling.
De codebase onder de loep: 7 900 bestanden, 144 000 regels
Voordat u de kosten van de training schat, moet u weten wat u moet trainen. Ik heb mijn werkruimte geauditeerd door alles wat door Git wordt genegeerd strikt uit te sluiten :
----
----
----
build/    out/    node_modules/    runtimes/    .gradle/    dist/
target/   venv/   __pycache__/     .cache/      .tox/
----

Hier is het resultaat voor alleen de getrackte bestanden :

[cols="2,2"]
|===
|metriek |Waarde

|bijgehouden bronbestanden |**7 896** |regels code (LOC) |**143 805** |Git-opslagplaatsen |**26** |Hoofdtalen |Kotlin (1 903), AsciiDoc (2 765), Python (5 029)
|===

[IMPORTANT]
====
Deze 5.000+ Python-bestanden bevatten de`runtimes/`notitieblokken en hulpscripts. De applicatiekern (Gradle-plug-ins, DAG-engine, agents) is vooral in Kotlin en AsciiDoc.
====

Van deze massa schat ik dat ik een synthetisch dataset kan genereren van**~170 miljoen tokens**via een instructeur LLM (distillatie van de codebase naar instructie/antwoordparen).

=== Detail van de dataset per type deskundige

[source,text]
----
Dataset maître (généraliste V4-Flash) :    50M tokens
Expert Gradle/Build        :    15M tokens
Expert Kotlin/DAG          :    15M tokens
Expert AsciiDoc/Gouvernance:    15M tokens
Expert Agent/LLM/Python    :    15M tokens
Expert Infra/CI-CD         :    15M tokens
Micro-experts Qwen/Gemma   :   ~5M tokens chacun
----

== De keuze van de modellen: 100% MoE, geen dicht

Daar wordt de architectuur echt efficiënt.

Een *dense* model activeert al zijn gewichten bij elke token. Een *MoE* (Mixture of Experts) model activeert alleen een fractie van zijn parameters. De inferentiekosten — en die van fine-tuning — zijn evenredig met de parameters.**geactiveerd**, niet naar de instellingen**opgeslagen**.

Laten we eens kijken wat de markt vandaag op het gebied van MoE aanbiedt op Ollama Cloud:

[cols="3,2,2,1,3"]
|===
|Model |Totaal parameters |Geactiveerd |Activering |Ollama Wolk

|DeepSeek V4-Pro |1.6T |49B |3.1% |✅ inheems |DeepSeek V4-Flash |292B |13B |4.5% |✅ inheems |Gemma 4 26B-A4B |26B |3,8 miljard |14.6% |✅ inheems |Qwen3.6-35B-A3B |35B |3B |8.6% |❌ (nog niet geïntegreerd) |Qwen3.5-35B-A3B |35B |3B |8.6% |natief
|❌ Qwen3.5-27B |27B |27B |100% dicht |geëlimineerd |❌ Qwen3.5-4B/9B |4B/9B |4B/9B |100% dicht |geëlimineerd |❌ Gemma 4 31B |31B |31B |100% dicht |verwijderd
|🧪 Gemma 4 E2B/E4B |5B/8B |5B/8B |100% dicht |validatiepijplijn
|===

[CAUTION]
====
De activatieratio is het discriminerende criterium. Een Gemma 4 26B-A4B activeert slechts 3,8B van zijn 26B parameters — dat is 7× minder dan een dense 27B, voor vergelijkbare coding agent‑prestaties (77,1% vs 80% op LiveCodeBench v6).
====

=== Waarom geef ik de dichte modellen op?

De uitzondering: de Gemma 4 E2B en E4B. Deze twee modellen, onder Apache 2.0, zijn perfect om een training‑pipeline te testen en te valideren tegen lage kosten. Een run van 2‑3 uur op een E2B kost minder dan $5 — als de dataset of de hyperparameters verkeerd zijn, weet je dat voor een paar dollar. Eenmaal de pipeline draaiende, kunnen ze zelfs worden gebruikt voor ultra‑microtaken (triviaal herformateren, binaire classificatie). Maar voor de experts van de hoofdvloot blijf ik bij MoE. Daarom:

.Maar niet alleen: de Gemma 4 E2B/E4B, experts van fijne anonimisering

[NOTE]
====
Google heeft deze kleine modellen ontworpen als competitief in native tool calling — ze kunnen functies aanroepen, regex manipuleren, patronen zoeken. Zodra ze zijn gefinetuned op voorbeelden van anonimisering (e-mails, tokens, UUIDs, bestandspaden), worden ze**anoniemmakers van dataset**ultra-snel. We geven ze een blok onbewerkte tekst, ze noemen`sed`/`regex`via een tool call en retourneren ze het opgeschoonde blok. De inferentiekost is verwaarloosbaar: 5B geactiveerd, het past op een enkele entry-level GPU. Deze modellen zijn geen vakexperts — het zijn**gespecialiseerde arbeiders**in de productieketen van de dataset.
====

* De trainings-VRAM (zelfs in QLoRA) is evenredig met**27B totaal**
* Zijn trainingsduur is evenredig met**27B geactiveerd**

Laten we vergelijken met een Qwen3.6-35B-A3B (MoE) :

[cols="3,2,2,2"]
|===
| |Qwen3.5-27B (dense) |Qwen3.6-35B-A3B (MoE) |verhouding

|VRAM QLoRA |~55 GB |~35 GB |1.6× |GPU-uren (8M tok) |~12u |~4 uur |**3×** |Kosten per fine-tune |~$24 |~$8 |**3×** |SWE-bench geverifieerd |75.0% |73.4% |vergelijkbaar
|===

De MoE kost 3× minder om te trainen voor agent-codingprestaties binnen 5%. Bij 22 experts loopt het verschil in de duizenden euro's.

== Schatting van de training : 811 H100-uren

Ik heb de trainingskosten per model verspreid, in QLoRA 4-bit, met de hierboven beschreven datasets.

=== lichtgewicht MoE micro-experts (3-3.8B geactiveerd)

Deze modellen vereisen 1 H100 (80 GB) per run. De VRAM van het model in Q4 is ongeveer 13-18 GB, waardoor er voldoende ruimte overblijft voor de LoRA-optimisatietoestanden en de activaties.

[cols="4,2,3,2"]
|===
|Model |Aantal runs |GPU-h/run |Totaal GPU-uren

|Gemma 4 26B-A4B-FT |6 |3.5 h |**21 u** |Qwen3.6-35B-A3B-FT |5 |4.0 h |**20 uur** |Qwen3.5-35B-A3B-FT |5 |4.0 h |**20 uur** |*Subtotaal micro* | | |*61 h*
|===

=== Directieleden V4-Flash (13B geactiveerd / 292B opgeslagen)

DeepSeek V4-Flash is een speciaal geval. Hoewel alleen 13B per token wordt geactiveerd, weegt het volledige model in Q4 ~142 GB — alle experts moeten in VRAM zijn tijdens de training. Het is dus**3× H100**voor run om comfortabel te zijn

[cols="4,2,3,3,2"]
|===
|model |Dataset |GPU's |Uren |Totaal GPU-u

|V4-Flash-Base generiek |50M tok |3× H100 |50 h |**150 u** |V4-Flash deskundige ×5 |15M tok |3× H100 |40 h |**600 u** |*Subtotaal leidinggevenden* | | | |*750 h*
|===

[cols="3,2,1"]
|===
|**totaal** | |**811 H100-h**
|===

[NOTE]
====
Ter vergelijking, een full fine-tune van V4-Flash (zonder QLoRA, alle gewichten) zou ~4 000 H100-uur kosten alleen voor de 6 modellen. QLoRA deelt de kosten door 5. Dit is de enige manier om het project economisch haalbaar te maken op deze schaal.
====

=== GPU-prijzen: wie huurt wat in mei 2026

Ik heb de belangrijkste verhuurders van H100 gebenchmarked. De prijs per meter, voor 811 uur.

[cols="3,2,2,2"]
|===
|verhuurder |$/H100·h |Totaal 811h |Betrouwbaarheid

|**Vast.ai plek** |$1.60 |**$1 298** |★★☆ onderbrekbaar |**Crusoe Cloud** |$2.00 |**$1.622** |★★★★ betrouwbaar datacenter |FluidStack |$1.98 |$1 606 |★★★ |TensorDock |$1.80 |$1 460 |(empty) |RunPod |$2.29 |$1 857 |★★★ goed compromis |CoreWeave |$2.25 |$1 825 |★★★★ onderneming |Lambda Labs |$2.49 |$2 019 |★★★★ premium
|===

[TIP]
====
Vast.ai spot is het goedkoopst maar je runs kunnen op elk moment worden onderbroken. Voor training is dat riskant. Crusoe van $2,00/uur biedt de beste prijs-kwaliteitverhouding. De extra kosten van $324 ten opzichte van Vast zijn de gemoedsrust waard.
====

=== Wandklok : hoe lang duurt het om alles te trainen ?

Met één enkele node 3× H100 nemen de 31 runs (1 generalist + 30 experts) ongeveer**12 dagen**sequentieel. Als je 2 knooppunten in parallel huurt, daalt het tot**6 dagen**.

In de praktijk kunnen micro-experts draaien op afzonderlijke knooppunten (elk 1 H100) terwijl V4-Flash het 3× H100-knooppunt belegt. Met een intelligente planning :

----

Nœud A (3× H100) : V4-Flash généraliste → V4-Flash experts ×5       (11 jours) Nœud B (1× H100) : Gemma 4 26B ×6 → Qwen 36 ×5 → Qwen 35 ×5        (6 jours)

7 dagen huur, alles opgevouwen.

== De inferentie: 23 modellen op Ollama Cloud vanaf 17€/maand

Het is het meest elegante deel van de architectuur.

Ollama Cloud staat het uploaden van privé-modellen toe (functie van het Pro-abonnement). Mijn 22 gefijntuned modellen worden geplaatst in`.gguf`op mijn Ollama ruimte, gemarkeerd als privé, en toegankelijk via de standaard API.

[plantuml, inference-flow, svg]
----
@startuml
skinparam backgroundColor #FAFAFA
skinparam defaultFontSize 12

|Utilisateur|
start
:Tâche de développement;

|Orkestrateur (V4-Pro)|
:Classifier la tâche\n(domaine + complexité);
if (Tâche simple,\nspécialisée ?) then (oui)
  :Router vers micro-expert\n(Gemma 4 26B-A4B-FT\n ou Qwen3.6-35B-A3B-FT);
elseif (Tâche complexe,\nconventions fortes ?) then (oui)
  :Router vers exécutif\n(V4-Flash-FT);
else (non)
  :Résoudre avec V4-Pro\n(architecture, décision);
endif

|Modèle ciblé|
:Génère le code/output\n**dans mon style**,\n90%+ first-shot correct;
:Retourne la réponse;

stop
@enduml
----

=== We beginnen bij €17 per maand, we schalen op indien nodig.

Het Pro Ollama-abonnement (17€/maand bij jaarlijkse betaling) staat 3 concurrerende cloud-modellen toe. In deze architectuur heb ik nooit meer dan 2-3 experts tegelijk nodig :

* De classificatiefase (V4-Pro) neemt 1 slot in beslag, enkele seconden
* De doelgerichte expert neemt 1 slot in, de tijd om zijn/haar antwoord te genereren
* Het 3e slot blijft in reserve voor de parallelle taken

Als het gebruik toeneemt, voeg ik extra Pro-accounts toe via de Docker-methode beschreven in xref:0120_cumuler_deux_abonnements_ollama_pro_docker_post.adoc[mijn artikel over het combineren van abonnementen]. Geen Max-plan van 100€/maand — ik voeg alleen toe wat ik echt nodig heb.

De enige beperkende factor is de**GPU‑tijdquota**maandelijks van Ollama (50× het gratis plan voor Pro). Voor mijn gebruik van een paar honderd verzoeken per dag, het is ruimschoots voldoende.

[IMPORTANT]
====
De marginale kosten van een aanroep van V4-Pro (49B geactiveerd) vs Gemma 4 26B-A4B (3.8B geactiveerd) is het**zelfs voor mij : nul**. Dit is het Ollama-abonnement dat het verschil in rekenkracht absorbeert. Mijn enige indicator is de latentie.
====

=== Het routing in de praktijk

----

Volume de requêtes estimé : ~500/jour

├─ 50% → Gemma 4 26B-A4B-FT    (micro, 3.8B actifs) │        Formatage AsciiDoc, scripts simples, conventions nommage │ ├─ 25% → V4-Flash-FT            (exécutif, 13B actifs) │        Plugins Gradle, refactoring Kotlin, génération DAG │ ├─ 15% → Qwen 35B MoE-FT       (micro, 3B actifs) │        Tâches intermédiaires, review de code, documentation │ └─ 10% → V4-Pro                 (orkestrateur, 49B actifs) Décisions architecturales, refactoring transverse, problèmes vraiment nouveaux

Het gros van het verkeer loopt via de kinderen. Het grote model grijpt alleen in als laatste redmiddel.

== De vergelijking die pijn doet : Claude, GPT, Gemini, Grok vs mijn vloot

Hier wordt het verschil duizelingwekkend. Laten we eens kijken wat dezelfde hoeveelheid werk (500 verzoeken/dag, ~300 invoertokens + 2 000 uitvoerttokens gemiddeld) zou kosten met de proprietair oplossingen op de markt in mei 2026.

=== Anthropic — Claude (tarieven mei 2026)

Anthropic heeft onlangs zijn prijzen *verlaagd*. De druk van open-weight-oplossingen zoals DeepSeek en Qwen wordt gevoeld.

[cols="3,2,2,2,2"]
|===
|model |$/MTok |Output $/MTok |Kosten per dag |**Kosten/maand**

|Opus 4.7 (de meest intelligente) |$5 |$25 |$25.75 |**$772** |Sonnet 4.6 (gebalanceerd) |$3 |$15 |$15.45 |**$463** |Haiku 4.5 (de snelste) |$1 |$5 |$5.15 |**$154**
|===

[CAUTION]
====
Deze tarieven zijn *na* de laatste prijsverlaging van Anthropic (mei 2026). Daarvoor was Opus $15/$75 per MTok. De angst voor open-weight is echt.
====

Zelfs het goedkoopste model van Claude — Haiku 4.5 voor**154€/maand**— kost 9× meer dan mijn Ollama Pro-abonnement van 17€. En Haiku kent mijn codebase niet, genereert niet in mijn stijl, en vereist systematisch prompt engineering.

De meest intelligente — Opus 4.7 — explodeert het budget bij**772€/maand**voor een bescheiden volume van 500 verzoeken per dag. Of**45× duurder**dan mijn oplossing.

=== OpenAI — GPT (tarieven mei 2026)

[cols="3,2,2,2,2"]
|===
|Model |$/MTok |$/MTok |Kosten/dag |**Kosten per maand**

|GPT 5.5 (het meest intelligente) |$5 |$30 |$30.90 |**$927** |GPT 5.4 (standaard) |$2.50 |$15 |$15.45 |**$463** |GPT 5.4 Mini |$0.75 |$4.50 |$4.64 |**$139**
|===

Zelfs het 'economische' model van OpenAI — GPT 5.4 Mini van 139€ per maand — kost 8 keer mijn abonnement, voor een model dat *niets* weet van mijn conventies en vereist zwaar prompt engineering.

GPT 5.5, hun vlaggenschip :**927€/maand**.Voor *zero-shot* op mijn codebase. Met 2-3 iteraties per taak omdat de stijl niet onder controle is, verdubbelt de werkelijke maandelijkse kosten gemakkelijk.

=== Google — Gemini (tarieven mei 2026)

[cols="3,2,2,2,2"]
|===
|model |$/MTok |Output $/MTok |kosten per dag |**Kosten/maand**

|Gemini 3.1 Pro (High) |$3.50 |$17.50 |$18.00 |**$540** |Gemini 3.1 Pro |$2 |$10 |$10.30 |**$309** |Gemini 3 Flash |$0.30 |$1.50 |$1.54 |**$46**
|===

Gemini 3 Flash voor €46 per maand is prijscompetitief — maar zonder fine-tune genereert het « generieke » code. Geen *Cheroliv*-code.

=== Grok—xAI (tarieven mei 2026)

[cols="3,2,2,2,2"]
|===
|Model |$/MTok |Output $/MTok |Kosten per dag |**Kosten/maand**

|Grok 4 |$4 |$16 |$16.48 |**$494** |Grok 4 Mini |$0.80 |$3.20 |$3.30 |**$99**
|===

=== Microsoft — Azure OpenAI (tarieven mei 2026)

Azure hanteert dezelfde prijzen als de directe OpenAI API, maar rekent bovendien de infrastructuur en het netwerk in rekening. Er moet rekening worden gehouden met een meerprijs van 10-20% voor de beheerde service.

[cols="3,2,2,2,2"]
|===
|Model |$/MTok |Output $/MTok |Kosten/dag |**Kost/maand**

|GPT 5.4 (Azure, Wereldwijd) |$2.50 |$15 |$15.45 |**$463** |GPT 5.4 + infrastructuur |opslag 15% |toeslag 15% |$17.77 |**$533**
|===

[NOTE]
====
De tarieven hierboven betreffen de API, niet de abonnementen « chat » (Claude Pro à $20/maand, ChatGPT Plus à $20/maand). We vergelijken hier het *ontwikkelaar*gebruik, waarbij je honderden verzoeken per dag via de API achter elkaar plaatst om te genereren, te refactoren en te documenteren. De abonnementen voor het grote publiek hebben quotas die al vóór 500 verzoeken/dag exploderen.
====

=== De vergelijkende eindtabel

[cols="3,2,2,2,2,2"]
|===
|Oplossing |Kennis codebase |Geïntegreerde stijl |Kosten/maand |Iteraties |**Effectieve kosten**

|**Mijn vloot (Ollama Pro)** |✅ Gefinetuned |In de gewichten |**17€** |0-1 |**17€** |Claude Opus 4.7 |❌ Zero-shot |❌ Nodige prompt |$772 |2-3 |$1 500-2 300 |Claude Haiku 4.5 |Zero-shot |❌ Vereiste prompt |$154 |3-4 |$460-615 |GPT 5.5 |❌ Zero-shot |❌ Noodzakelijke prompt |$927 |2-3 |$1 854-2 781 |GPT 5.4 |❌ Zero-shot |❌ noodzakelijke prompt |$463 |2-3 |$925-1 390 |GPT 5.4 Mini |❌ Zero-shot |❌ Vereiste prompt |$139 |3-5 |$417-695 |Gemini 3.1 Pro High |❌ Zero-shot |❌ Benodigde prompt |$540 |2-3 |$1 080-1 620 |Grok 4 |❌ Zero-shot |❌ Vereiste prompt |$494 |2-3 |$988-1 482 |**Azure GPT 5.4** |❌ Zero-shot |❌ Prompt nodig |$533 |2-3 |$1 066-1 600
|===

[plantuml, cost-comparison, svg]
----
@startuml
skinparam backgroundColor #FAFAFA

title Kosten/efficiëntie-rapport — mijn vloot vs de markt (mei 2026)
rectangle "17€/maand" as OURS #4ECDC4
rectangle "Opus 4.7\n772€" as OPUS #FF6B6B
rectangle "Sonnet 4.6\n463€" as SONNET #FF8B94
rectangle "GPT 5.5\n927€" as GPT #FFD93D
rectangle "Gemini 3.1 Pro\n540€" as GEMINI #6C5CE7
rectangle "Grok 4\n494€" as GROK #A8E6CF
rectangle "Haiku 4.5\n154€" as HAIKU #DFE6E9
rectangle "GPT 5.4 Mini\n139€" as MINI #B2BEC3

note bottom of OURS
  Avec fine-tune intégré.
  Zéro prompt engineering.
  90%+ first-shot correct.
end note

@enduml
----

17€/maand voor 23 AI-experts die zijn afgesteld. Het vlaggenschip Claude Opus 4.7 kost**45 keer duurder**voor een lagere kwaliteit op *mijn* codebase. GPT 5.5 kost**54× duurder**. Zelfs het goedkoopste model op de markt (Gemini Flash voor 46€) kost**2.7× meer**zonder kennis van mijn werkruimte.

Het verdict is onherroepelijk: het fine-tunen op MoE-architecturen, in 2026, is niet alleen « goedkoper ». Het is een efficiëntiefactor van**27× tot 54×**over de kosten/kwaliteitsverhouding ten opzichte van de proprietair oplossingen. Anthropic, OpenAI, Google — zij weten het allemaal, en daarom verlagen zij hun prijzen in paniek.

== De efficiëntiefactor: 5-8× versus V4-Pro alleen gebruiken

Laten we de twee uitersten vergelijken.

=== Scenario A : V4-Pro alleen voor alles

[cols="3,2"]
|===
|Metriek |Waarde

|Kennis van de codebase |0 (zero-shot) |Naamgevingsconventie |40-60% eerste-schot correct |Prompt engineering nodig |Ja, systematisch |Iteraties per taak |2-3 |Kosten inferentie |$100/maand (Ollama Max) |Gemiddelde latentie |~20 tok/s + netwerk
|===

=== Scenario B: Vloot MoE georchestreerd

[cols="3,2"]
|===
|metrisch |Waarde

|Kennis van de codebase |Geïntegreerd (fine-tune) |Conventie naamgeving |90-95% eerste schoten correct |Prompttechniek |Nee (de stijl zit in de gewichten) |Iteraties per taak |0-1 |inferentiekosten |$60/maand (3× Ollama Pro) |Gemiddelde latentie |~50 tok/s (lichte modellen)
|===

[cols="4,2,2,2"]
|===
|Dimension |V4-Pro alleen |Vloot MoE |factor

|maandelijkse cloudkosten |$100 |**$60** |1.7× |Context om in te voegen |Hoog (prompt) |**nul** |∞ |Gemiddelde iteraties |2-3 |**0-1** |2-3× |Ervaren latentie |20 tok/s |50 tok/s |**2,5×** |Eerste schot correct |50% |90%+ |**1.8×**
|===

**Globale efficiëntiefactor: 5-8×**— in ervaren ontwikkelaarsproductiviteit.

[NOTE]
====
De factor wordt niet gemeten in tokens of in dollars. Hij wordt gemeten in « hoeveel tijd ik besteed aan het uitleggen aan het model wat het al zou moeten weten ». Met fine-tuned modellen neigt deze tijd naar nul.
====

== Het volledige budget: een eenmalige investering, een belachelijk pakket

[cols="3,2"]
|===
|positie |Bedrag

|Training GPU (811 H100-h, Crusoe $2/h) |**$1 622** |Synthetische datasetgeneratie (API LLM) |**$400** |Inference (Ollama Pro jaarlijks, $17/maand) |**$204** |**Totaal eerste jaar** |**$2.226** |**Maandelijks equivalent** |**$186** |**Geschatte kosten per aanvraag** |< $0.01
|===

[plantuml, budget-breakdown, svg]
----
@startuml
skinparam backgroundColor #FAFAFA

rectangle "Budget Jaar 1 : $2 226" as Total #E8E8E8 {
  rectangle "Training GPU\n$1 622 (73%)" as Train #FF6B6B
  rectangle "Dataset\ndestillatie\n$400 (18%)" as Data #FFE66D
  rectangle "Ollama Pro\n$204 (9%)" as Cloud #4ECDC4
}

note bottom of Total
   $186/mois équivalent année 1.
   Dès l'an 2 : $17/mois.
   Amorti par ~$235 de CA
   mensuel avec marge 95%.
end note

@enduml
----

$186/maand het eerste jaar,**$17/maand**Vanaf jaar 2. De prijs van een Netflix Premium-abonnement, voor een team van 23 AI-experts die 24/7 beschikbaar zijn, die code schrijven *in mijn stijl* zonder dat ik hun hoef uit te leggen wat mijn conventies zijn.

[plantuml, inference-flow, svg]
----
@startuml
skinparam backgroundColor #FAFAFA
skinparam defaultFontSize 12

|Utilisateur|
start
:Tâche de développement;

|Orkestrateur (V4-Pro)|
:Classifier la tâche\n(domaine + complexité);
if (Tâche simple,\nspécialisée ?) then (oui)
  :Router vers micro-expert\n(Gemma 4 26B-A4B-FT\n ou Qwen3.6-35B-A3B-FT);
elseif (Tâche complexe,\nconventions fortes ?) then (oui)
  :Router vers exécutif\n(V4-Flash-FT);
else (non)
  :Résoudre avec V4-Pro\n(architecture, décision);
endif

|Modèle ciblé|
:Génère le code/output\n**dans mon style**,\n90%+ first-shot correct;
:Retourne la réponse;

stop
@enduml
----

Met edster.cloud en zijn marge van ~95%, het break-evenpunt is op**~$2 340 extra omzet**op het jaar. In de praktijk :

* 1 missie voor softwarepiloten → $3 000-5 000 → gedekte investering + winst
* 1 bedrijfstraining → $5 000-10 000 → comfortabel
* De impliciete upsell: "mijn AI-team beheerst mijn softwareforge" → onderscheidend commercieel

Vanaf jaar 2 is de training niet meer te betalen (behoudens dataset-update). De jaarlijkse kosten dalen tot**$204**($17/mois). De kosten/waardeverhouding is die van een eenhoorn: bijna nul.

== De grenzen van de oefening

Dit blijft een *vingerveer*. Verschillende variabelen kunnen het budget beïnvloeden:

[cols="2,3"]
|===
|variabele |Impact

|Generatie van de synthetische dataset |Als de distillatie-API faalt (hallucinaties, verkeerd gevormde paren), is menselijke tijd nodig om te cureren. Verborgen kosten. |Quota's GPU-tijd Ollama |Als het gebruik de quotas van het Pro-plan overschrijdt, moet je upgraden of overstappen op een specifieke GPU. |werkelijke kwaliteit van fine-tunes |Een mislukte fine-tune → opnieuw doen. Het echte risico zijn de hyperparameters, niet de GPU-locatie. |Snelle evolutie van de modellen |Qwen3.6/Gemma 4 zijn minder dan een maand geleden uitgekomen. Over 6 maanden zal de volgende generatie beter zijn EN goedkoper om te finetunen.
|===

[WARNING]
====
Start niet 811 uur training zonder eerst de pijplijn te hebben getest op *één* micro-model. Een run van 3-4 uur op een Qwen 35B-A3B kost $8. Als de dataset slecht is, zul je het voor $8 weten, niet voor $1 622.
====

== Conclusie: het fine-tune is een toegankelijke luxe geworden

Een jaar geleden was het fine-tunen van een model met 292B parameters (zelfs in QLoRA) nog onderzoeksgebied. Vandaag, in mei 2026, is het een haalbaar project voor een onafhankelijke ontwikkelaar:

* **811 H100-uren**de training — $1 622 bij Crusoe
* **23 gespecialiseerde modellen**geladen op Ollama Cloud —**$17/maand**
* **0 server, 0 lokale GPU, 0 onderhoud infra**

Democratisering kwam voort uit drie convergerende factoren :

1. **De architecturen MoE**— die mogelijk maken efficiënt finetunen van modellen waarvan alleen een fractie van de gewichten wordt geactiveerd
2. **De vaste plannen van Ollama Cloud**— die een variabele kosten (per-token) omzetten in vaste kosten (abonnement)
3. **Hoogwaardige open-weight modellen**— DeepSeek V4, Qwen3.6, Gemma 4 zijn onder MIT/Apache 2.0-licenties

De beschaving gaat vooruit door het aantal belangrijke handelingen dat we kunnen uitvoeren zonder erbij na te denken te vergroten

Het fine-tune is precies dat: een bewerking die je aan de machine overdraagt zodat je er niet meer over hoeft na te denken. En in 2026 kost het minder dan een maandelijks betaalde juniorontwikkelaar.

---

_Artikel gepubliceerd op {jbake-date}_

== Fijnafgestelde modellen van de vloot

[cols="2,2,2,2,3"]
|===
|Grootte geactiveerd |nummer |Basismodel |domein |gegevensset

|13B |1 |DeepSeek-V4-Flash-Base |Workspace algemeen |50M tokens |13B |5 |DeepSeek-V4-Flash |Gradle, Kotlin, DAG, Doc, Infra |15M tokens |3.8B |6 |Gemma 4 26B-A4B |Microtaken, opmaak, scripts |5 miljoen tokens |3B |5 |Qwen3.6-35B-A3B |Refactoring, review, tussentijds document |5M tokens |3B |5 |Qwen3.5-35B-A3B |Legacy taken, compatibiliteit |5M tokens
|===

== Bronnen

=== open-weight modellen op HuggingFace

* https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash-Base[DeepSeek V4-Flash-Base — 292B parameters, licentie MIT]
* https://huggingface.co/Qwen/Qwen3.6-35B-A3B[Qwen3.6-35B-A3B — 35B/3B geactiveerd, licentie Apache 2.0]
* https://huggingface.co/Qwen/Qwen3.5-35B-A3B[Qwen3.5-35B-A3B — 35B/3B geactiveerd, Apache 2.0-licentie]
* https://huggingface.co/google/gemma-4-26B-A4B-it[Gemma 4 26B-A4B — 26B/3.8B geactiveerd, licentie Apache 2.0]

=== Bronnen van de tarieven (mei 2026)

* https://ollama.com/pricing[Ollama Cloud tarieven — Pro‑plan $17/maand, jaarlijks]
* https://www.anthropic.com/pricing[Anthropic tarieven — Claude API (Opus 4.7 $5/$25, Sonnet 4.6 $3/$15, Haiku 4.5 $1/$5)]
* https://openai.com/api/pricing/[OpenAI-tarieven — GPT API (GPT 5.5 $5/$30, GPT 5.4 $2,50/$15)]
* https://deepinfra.com/pricing[DeepInfra tarieven — GPU-instanties H100 $1,79/uur, B200 $2,79/uur]
* Vast.ai, Crusoe Cloud, FluidStack, TensorDock, RunPod, CoreWeave, Lambda Labs — handmatige prijsregistraties, gedateerd mei 2026

=== Officiële aankondigingen

* https://qwen.ai/blog?id=qwen3.6-35b-a3b[Officiële aankondiging Qwen3.6-35B-A3B — blog Qwen]— agentic coding, Apache 2.0, 262K context

[cols="3,2,2,2,2"]
|===
|Model |Input $/MTok |$/MTok |Kosten/dag |**Kosten/maand**

|Grok 4 |$4 |$16 |$16.48 |**$494** |Grok 4 Mini |$0.80 |$3.20 |$3.30 |**$99**
|===

=== Microsoft — Azure OpenAI (tarieven mei 2026)

Azure hante dezelfde prijzen als de directe OpenAI API, maar brengt extra kosten in rekening voor de infrastructuur en het netwerk. Men moet rekenen op een meerprijs van 10-20% voor de beheerde service.

[cols="3,2,2,2,2"]
|===
|Model |$/MTok |Output $/MTok |Kosten/dag |**Kosten/maand**

|GPT 5.4 (Azure, Global) |$2.50 |$15 |$15.45 |**$463** |GPT 5.4 + infrastructuur |meerprijs 15% |meerprijs 15% |$17.77 |**$533**
|===

[NOTE]
====
De bovenstaande tarieven hebben betrekking op de API, niet op de "chat"-abonnementen (Claude Pro voor $20/maand, ChatGPT Plus voor $20/maand). We vergelijken hier het *ontwikkelaarsgebruik*, waarbij je dagelijks honderden aanvragen via de API achter elkaar plaatst om te genereren, te refactoren of te documenteren. Consumentenabonnementen hebben quota die al lang voor de 500 aanvragen/dag zijn verbruikt.
====

=== De uiteindelijke vergelijkingstabel

[cols="3,2,2,2,2,2"]
|===
|Oplossing |Kennis van de codebase |Geïntegreerde stijl |Kosten/maand |Iteraties |**Effectieve kosten**

|**Mijn vloot (Ollama Pro)** |✅ Fine-tuned |✅ In de gewichten |**17€** |0-1 |**17€** |Claude Opus 4.7 |❌ Zero-shot |❌ Prompt vereist |$772 |2-3 |$1 500-2 300 |Claude Haiku 4.5 |❌ Zero-shot |❌ Prompt vereist |$154 |3-4 |$460-615 |GPT 5.5 |❌ Zero-shot |❌ Prompt vereist |$927 |2-3 |$1 854-2 781 |GPT 5.4 |❌ Zero-shot |❌ Prompt vereist |$463 |2-3 |$925-1 390 |GPT 5.4 Mini |❌ Zero-shot |❌ Prompt vereist |$139 |3-5 |$417-695 |Gemini 3.1 Pro High |❌ Zero-shot |❌ Prompt vereist |$540 |2-3 |$1 080-1 620 |Grok 4 |❌ Zero-shot |❌ Prompt vereist |$494 |2-3 |$988-1 482 |**Azure GPT 5.4** |❌ Zero-shot |❌ Prompt vereist |$533 |2-3 |$1 066-1 600
|===

[plantuml, cost-comparison, svg]
----
@startuml
skinparam backgroundColor #FAFAFA

title Kosten/efficiëntie-verhouding — mijn vloot vs de markt (mei 2026)
rectangle "17€/maand" as OURS #4ECDC4
rectangle "Opus 4.7\n772€" as OPUS #FF6B6B
rectangle "Sonnet 4.6\n463€" as SONNET #FF8B94
rectangle "GPT 5.5\n927€" as GPT #FFD93D
rectangle "Gemini 3.1 Pro\n540€" as GEMINI #6C5CE7
rectangle "Grok 4\n494€" as GROK #A8E6CF
rectangle "Haiku 4.5\n154€" as HAIKU #DFE6E9
rectangle "GPT 5.4 Mini\n139€" as MINI #B2BEC3

note bottom of OURS
Met geïntegreerde fine-tune.
Nul prompt engineering.
90%+ first-shot correct.
end note

@enduml
----

17€/maand voor 23 fine-tuned AI-experts. Het vlaggenschip Claude Opus 4.7 kost**45× duurder**voor een lagere kwaliteit op *mijn* codebase. GPT 5.5 kost**54× duurder**. Zelfs het goedkoopste model op de markt (Gemini Flash voor 46€) kost**2,7× plus**zonder kennis van mijn workspace.

Het verdict is onherroepelijk: fine-tuning op MoE-architecturen is in 2026 niet gewoon "goedkoper". Het is een efficiëntiefactor van**27× tot 54×**op de kosten-kwaliteitsverhouding vergeleken met propriëtaire oplossingen. Anthropic, OpenAI, Google — ze weten het allemaal, en dat is waarom ze in paniek hun prijzen verlagen.

== De efficiëntiefactor: 5-8× vs het alleen gebruiken van `V4-Pro

Laten we de twee extremen vergelijken.

=== Scenario A: V4-Pro alleen voor alles

[cols="3,2"]
|===
|Metriek |Waarde

|Kennis van de codebase |0 (zero-shot) |Naamgevingsconventie |40-60% in één keer correct |Prompt engineering nodig |Ja, systematisch |Iteraties per taak |2-3 |Inferencekosten |$100/maand (Ollama Max) |Gemiddelde latentie |~20 tok/s + netwerk
|===

=== Scenario B: Georkestreerde MoE-vloot

[cols="3,2"]
|===
|Metriek |Waarde

|Kennis van de codebase |Geïntegreerd (fine-tune) |Naamgevingsconventie |90-95% first-shot correct |Prompt engineering |Nee (de stijl zit in de gewichten) |Iteraties per taak |0-1 |Inferentiekosten |$60/maand (3× Ollama Pro) |Gemiddelde latentie |~50 tok/s (lichtgewicht modellen)
|===

[cols="4,2,2,2"]
|===
|Dimensie |Alleen V4-Pro |MoE-vloot |Factor

|Maandelijkse cloudkosten |$100 |**$60** |1.7× |Te injecteren context |Hoog (prompt) |**Nul** |∞ |Gemiddelde iteraties |2-3 |**0-1** |2-3× |Waargenomen latentie |20 tok/s |50 tok/s |**2,5×** |Please provide the text you would like me to translate. |50% |90%+ |**1.8×**
|===

**Totale efficiëntiefactor: 5-8×**— en waargenomen developer-productiviteit.

[NOTE]
====
De factor wordt niet gemeten in tokens of dollars. Het wordt gemeten in « hoeveel tijd ik besteed aan het uitleggen aan het model wat het eigenlijk al zou moeten weten ». Bij fine-tuned modellen neigt deze tijd naar nul.
====

== Het volledige budget: een eenmalige investering, een belachelijk forfait

[cols="3,2"]
|===
|Post |Bedrag

|Training GPU (811 H100-h, Crusoe $2/u) |**$1 622** |Genereren van synthetische dataset (LLM API) |**$400** |Inference (Ollama Pro jaarlijks, $17/maand) |**$204** |**Totaal eerste jaar** |**$ 2 226** |**Maandelijks equivalent** |**$186** |**Geschatte kosten per aanvraag** |< $0.01
|===

[plantuml, budget-breakdown, svg]
----
@startuml
skinparam backgroundColor #FAFAFA

rectangle "Budget Jaar 1 : $2 226" as Total #E8E8E8 {
  rectangle "Training GPU\n$1 622 (73%)" as Train #FF6B6B
  rectangle "Dataset\ndistillation\n$400 (18%)" as Data #FFE66D
  rectangle "Ollama Pro\n$204 (9%)" as Cloud #4ECDC4
}

note bottom of Total
$186/maand equivalent jaar 1.
Vanaf jaar 2: $17/maand.
Afgeschreven door ~$235 maandelijkse omzet met 95% marge.
end note

@enduml
----

$186/maand het eerste jaar,**$17/maand**vanaf jaar 2. De prijs van een premium Netflix-abonnement, voor een team van 23 AI-experts die 24/7 beschikbaar zijn en code schrijven *in mijn stijl* zonder dat ik hen mijn conventies hoef uit te leggen.

=== De rendementsberekening

Met edster.cloud en een marge van ~95% ligt het break-even punt op**~$2 340 extra omzet**over het jaar. In de praktijk:

* 1 software-begeleidingsmissie → $ 3 000-5 000 → investering gedekt + winst
* 1 corporate training → $5 000-10 000 → comfortabel
* De impliciete upsell: "mijn AI-team beheerst mijn softwareforge" → commercieel onderscheidend vermogen

Vanaf jaar 2 hoeft de training niet meer betaald te worden (behalve bij een update van de dataset). De jaarlijkse kosten dalen naar**$204**($17/maand). De kosten-batenverhouding is die van een eenhoorn: nagenoeg nul.

== De beperkingen van de oefening

Dit blijft een *ruwe schatting*. Meerdere variabelen kunnen het budget beïnvloeden:

[cols="2,3"]
|===
|Variabele |Impact

|Genereren van de synthetische dataset |Als de distillatie-API kuren (hallucinaties, verkeerd gevormde paren), is er menselijke tijd nodig voor curatie. Verborgen kosten. |GPU-tijd quota's Ollama |Als het gebruik de quota van het Pro-plan overschrijdt, is het nodig om naar een hoger plan over te stappen of over te schakelen naar een dedicated GPU. |Effectieve kwaliteit van de fine-tunes |Een mislukte fine-tune → opnieuw doen. Het echte risico zijn de hyperparamètres, niet de GPU-huur. |Snelle evolutie van modellen |De Qwen3.6/Gemma 4 zijn minder dan een maand geleden uitgebracht. Over 6 maanden zal de volgende generatie beter EN goedkoper zijn om te fine-tunen.
|===

[WARNING]
====
Start geen 811 uur training zonder eerst de pipeline te hebben getest op *één enkel* micro-model. Een run van 3-4 uur op een Qwen 35B-A3B kost $8. Als de dataset waardeloos is, weet je dat voor $8, niet voor $1 622.
====

== Conclusie: fine-tuning is een toegankelijke luxe geworden

Een jaar geleden was het fine-tunen van een model met 292B parameters (zelfs met QLoRA) nog een kwestie van onderzoek. Vandaag, in mei 2026, is het een haalbaar project voor een onafhankelijke ontwikkelaar:

* **811 H100-uren**de training — $1 622 bij Crusoe
* **23 gespecialiseerde modellen**geladen op Ollama Cloud —**$17/maand**
* **0 servers, 0 lokale GPU's, 0 infra-onderhoud**

De democratisering is voortgekomen uit drie convergente factoren:

1. **De MoE-architecturen**— waarmee modellen waarvan slechts een fractie van de gewichten is geactiveerd, efficiënt gefine-tuned kunnen worden
2. **De vaste abonnementen van Ollama Cloud**— die een variabele kost (per token) omzetten in een vaste kost (abonnement)
3. **Kwaliteits open-weight modellen**— DeepSeek V4, Qwen3.6, Gemma 4 vallen onder MIT/Apache 2.0-licenties

De beschaving vordert door het aantal belangrijke handelingen uit te breiden die we kunnen uitvoeren zonder erbij na te denken.

Fine-tuning is precies dat: een operatie die je uitbesteedt aan de machine zodat je er niet meer over na hoeft te denken. En in 2026 kost dat minder dan een junior developer in vaste dienst.

---

_Artikel gepubliceerd op {jbake-date}_

== Fine-tuned modellen van de vloot

[cols="2,2,2,2,3"]
|===
|Geactiveerde grootte |Aantal |Basismodel |Domein |Dataset

|13B |1 |DeepSeek-V4-Flash-Base |Algemene werkruimte |50M tokens |13B |5 |DeepSeek-V4-Flash |Gradle, Kotlin, DAG, Doc, Infra |15M tokens |3,8 miljard |6 |Gemma 4 26B-A4B |Microtaken, opmaak, scripts |5M tokens |3B |5 |Qwen3.6-35B-A3B |Refactoring, review, tussenliggend document |5M tokens |3B |5 |Qwen3.5-35B-A3B |Legacy-taken, compatibiliteit |5M tokens
|===

== Bronnen

=== Open-weight modellen op HuggingFace

* https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash-Base[DeepSeek V4-Flash-Base — 292B params, licentie MIT]
* https://huggingface.co/Qwen/Qwen3.6-35B-A3B[Qwen3.6-35B-A3B — 35B/3B geactiveerd, Apache 2.0-licentie]
* https://huggingface.co/Qwen/Qwen3.5-35B-A3B[Qwen3.5-35B-A3B — 35B/3B geactiveerd, Apache 2.0-licentie]
* https://huggingface.co/google/gemma-4-26B-A4B-it[Gemma 4 26B-A4B — 26B/3.8B geactiveerd, Apache 2.0-licentie]

=== Bronnen van de tarieven (mei 2026)

* https://ollama.com/pricing[Ollama Cloud Tarieven — Pro-plan $17/maand jaarlijks]
* https://www.anthropic.com/pricing[Anthropic-tarieven — Claude API (Opus 4.7 $5/$25, Sonnet 4.6 $3/$15, Haiku 4.5 $1/$5)]
* https://openai.com/api/pricing/[OpenAI-tarieven — GPT API (GPT 5.5 $5/$30, GPT 5.4 $2.50/$15)]
* https://deepinfra.com/pricing[DeepInfra Tarieven — GPU-instanties H100 $1,79/u, B200 $2,79/u]
* Vast.ai, Crusoe Cloud, FluidStack, TensorDock, RunPod, CoreWeave, Lambda Labs — handmatige prijslijsten, gedateerd mei 2026

=== Officiële mededelingen

* https://qwen.ai/blog?id=qwen3.6-35b-a3b[Officiële aankondiging Qwen3.6-35B-A3B — Qwen-blog]— agentic coding, Apache 2.0, 262K context