DGX Spark vs Cloud vs LLM-Abonnements — Der Wirtschaftsbenchmark, der den Traum von lokaler Hardware tötet
Publié le 06 May 2026
- Der Kontext: Ein Markt, der sich gewendet hat
- Das Optionen-Panel
- Einfache Inferenz: Der Tod der lokalen Hardware
- Fine-Tuning: Die Cloud ist unschlagbar
- Der einzige wahre Grund: Die Souveränität der Daten
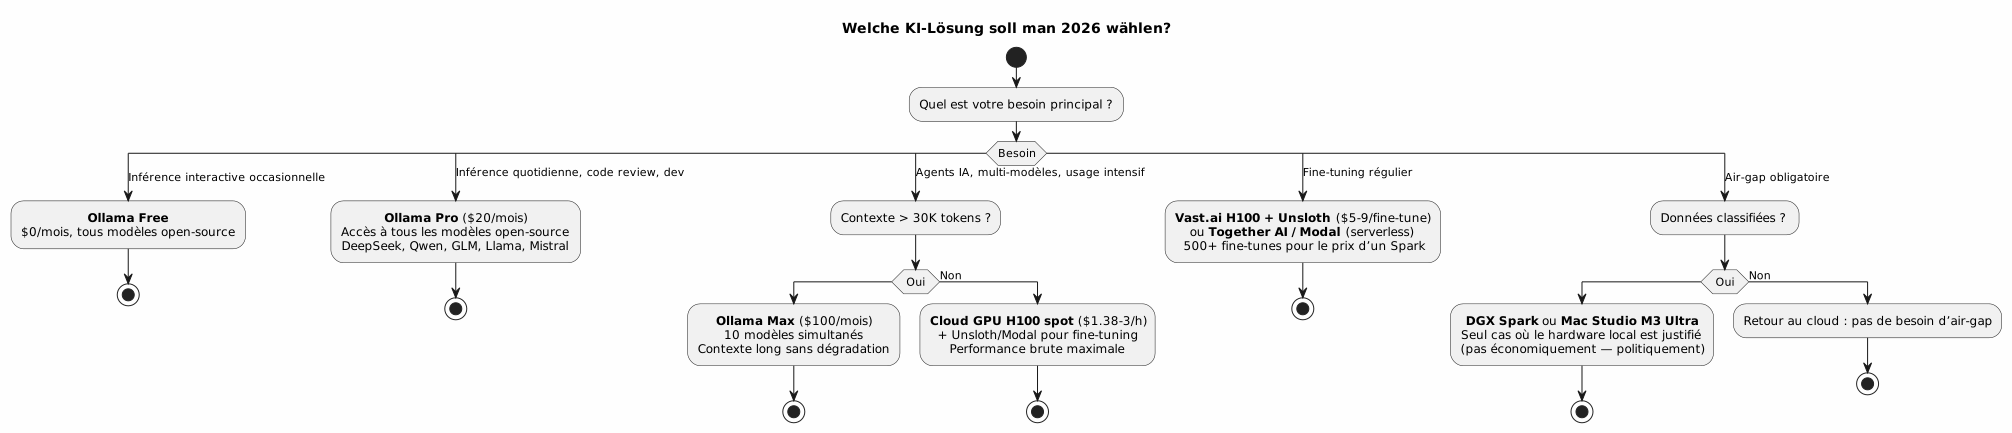
- Zusammenfassung: Die Entscheidungsmatrix
- Der Sonderfall: Das Pro-Abonnement gegenüber den chinesischen Modellen
- Und Huawei?
- Fazit: Der Luxus der Nähe
NVIDIA verkauft den DGX Spark als „Desktop-KI-Supercomputer“ für 4 699 $. Ollama bietet seine Cloud-Modelle für 20 $/Monat an. Ein H100 wird bei Vast.ai für 1,38 $/Stunde gemietet. Und die chinesischen Open‑Source‑Modelle — DeepSeek, Qwen, GLM — sind überall verfügbar, kostenlos, ohne dass man eine Karte kaufen muss. Wofür genau dient also dieser Spark? Ich habe die Zahlen durchgerechnet.
- klopf
-
[]
Der Kontext: Ein Markt, der sich gewendet hat
Im Mai 2026 hat sich die KI-Landschaft im Vergleich zur Ankündigung des DGX Spark auf der CES 2025 grundlegend verändert. Drei Kräfte haben zusammengewirkt, um die Rechtfertigung lokaler Hardware zunehmend schwieriger zu machen :
-
Der Preisverfall der GPU-CloudEine H100 wird für zwischen 1,38 $ und 3 $/h vermietet, gegenüber 5–8 $/h vor 18 Monaten.
-
Die Explosion der chinesischen Open-Source-Modelle: DeepSeek-V4, Qwen-3, GLM-5 sind wettbewerbsfähig mit den westlichen Modellen, kostenlos verfügbar
-
Der Aufstieg der Managed-Inference-PlattformenOllama, Groq und Together AI bieten API zu aggressiven Preisen an, mit großzügigen kostenlosen Tarifen.
Der DGX Spark, angekündigt zu $2 999 und dann auf $4 699 erhöht, kommt in eine Welt, die ihn nicht mehr braucht.
Das Optionen-Panel
Hier sind die im Mai 2026 verfügbaren Lösungen zum Ausführen von LLMs, von der leichtesten bis zur schwersten :
Option |
Kosten |
VRAM / Kapazität |
Zugängliche Modelle |
Hauptbeschränkung |
Ollama kostenlos |
$0/Monat |
leichte Cloud |
Alle öffentlichen Modelle |
Eingeschränkte Nutzung, 1 Modell gleichzeitig |
Claude Pro |
$20/Monat (~$240/Jahr) |
N/A (API geschlossen) |
Nur Claude 4.x |
Einzigartiges Modell, kein Open-Source |
Ollama Pro |
$20/Monat (~$200/Jahr) |
Cloud medium |
Alle öffentlichen Modelle |
max. 3 gleichzeitige Modelle |
Ollama Max |
$100/Monat (~$1 200/Jahr) |
schwere Wolke |
Alle öffentlichen Modelle |
10 gleichzeitige Modelle |
Cloud-GPU (H100) |
$1.38-3/h |
80 Go HBM |
Alle Modelle, fine-tuning |
Stundenabrechnung, Setup erforderlich |
DGX Spark |
$4 699 (Kauf) |
128 Go unifié |
Tous modèles <128 Go |
Langsam (~10x weniger als ein H100), fest |
Mac Studio M3 Ultra |
~$5 000+ |
192 Go unifié |
Tous modèles <192 Go |
Nicht CUDA, MLX-Ökosystem |
|
Die genannten GPU-Cloud-Preise sind die von Vast.ai und RunPod im Mai 2026 — Spot/On-Demand, nicht reserviert. Die Preise der Hyperscaler (AWS, GCP, Azure) bleiben 2-3x höher. |
Was ich ausgeschlossen habe (und warum)
Ich habe die folgenden Optionen absichtlich von diesem Benchmark ausgeschlossen:
-
API von OpenAI / Anthropic / Google: Das Thema hier ist, open-source Modelle auszuführen, die man auswählen, fine-tunen und nicht von einem einzigen Anbieter abhängig sein kann.
-
Huawei Ascend / Atlas : Huawei ne commercialise pas d’équivalent desktop au DGX Spark. La gamme Ascend (910C, 910D) et Atlas (300I Duo, 350) est orientée datacenter — cartes PCIe, serveurs rack — pas des boîtiers compacts prêts à brancher. La puce Ascend 910C embarque 128 Go HBM mais c’est une puce serveur, pas un système autonome. L’Atlas 300I Duo offre 96 Go pour ~$1 400 mais nécessite une machine hôte
Einfache Inferenz: Der Tod der lokalen Hardware
Beginnen wir mit dem häufigsten Anwendungsfall: Chatten mit einem LLM, ein Code‑Review machen, Text generieren. Kein Fine‑Tuning, kein Batch‑Verarbeitung, lediglich interaktive Inferenz.
Die Berechnung
Ein DGX Spark zu $4 699. Wir teilen durch die jährlichen Kosten jedes Abonnements:
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 7) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Break-even-Punkt — DGX Spark ($4 699) vs Abonnements
rectangle "DGX Spark
$4 699" as spark #FFCDD2
^^^^^
 Syntax Error? (Assumed diagram type: activity)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Break-even-Punkt — DGX Spark ($4 699) vs Abonnements
rectangle "DGX Spark
$4 699" as spark #FFCDD2

rectangle "Ollama Pro
$200/Jahr" as opro #C8E6C9
rectangle "Claude Pro
$240 pro Jahr" as cpro #C8E6C9
rectangle "Ollama Max
$1.200 pro Jahr" as omax #FFF9C4
rectangle "Cloud H100
$3/h × 10h/Woche" as cloud #BBDEFB

spark --> opro : 23.5 années ⏳
spark --> cpro : 19.6 années ⏳
spark --> omax : 3.9 années
spark --> cloud : 3.0 années (à 10h/semaine, intermittent)

note bottom of spark
  Sans compter l'électricité (~$150/an)
  Sans compter l'obsolescence hardware
  Sans compter qu'il est 10x plus lent
end note

@enduml
Das Urteil ist brutal. Für die Inferenz:
-
Ollama Pro: Sie müssten23 Jahreum einen DGX Spark abzuschreiben. Der Spark wird seit 20 Jahren obsolet sein.
-
Ollama Max:4 Jahre— vorausgesetzt, man benutzt Spark 24/7, was niemand tut
-
Claude Pro: gleiches Problem,20 Jahrefür ein geschlossenes Einzelmodell
_ Das Versprechen des „Desktop‑KI‑Supercomputers“ stößt auf eine elementare Buchhaltungsrealität: $4.699 / $20 pro Monat = niemals rentabel für den individuellen Gebrauch. _
Selbst bei intensiver Nutzung
Nehmen wir das schlimmste Szenario für die Cloud an: Sie betreiben einen H100 8 Stunden pro Tag, 5 Tage pro Woche, 52 Wochen pro Jahr.
-
8 × 5 × 52 = 2.080 Stunden/Jahr
-
2 080 × $2/h (Durchschnittspreis Spot H100) =$4.160 pro Jahr
Der Spark ($4.699) rentiert sich in13 Monate. Ausser dass :
-
Der H100 ist~10x schnellerdas GB10 von Spark. Sie erledigen in 1 h, was Spark in 10 h erledigt. Bei gleichem Arbeitsvolumen kostet Ihnen der H100 $416/Jahr, nicht $4 160.
-
Le H100 a 80 Go HBM à 3.35 To/s de bande passante. Le Spark a 128 Go LPDDR5X à 273 Go/s. Pour les gros modèles, la bande passante compte plus que la capacité.
|
Der Vergleich von 1 h H100 mit 1 h Spark ergibt keinen Sinn. Der H100 erledigt die Arbeit 10× schneller. Der tatsächliche Cloud‑Kostenaufwand für eine gegebene Arbeitslast ist daher etwa 10× geringer als die naive Berechnung basierend auf den Stunden. |
Fine-Tuning: Die Cloud ist unschlagbar
Das klassische Argument der Verteidiger des Spark: „Ja, aber beim Fine-Tuning ist es anders.“
Nein, das ist es nicht.
Die reale Kosten eines Fine‑Tune
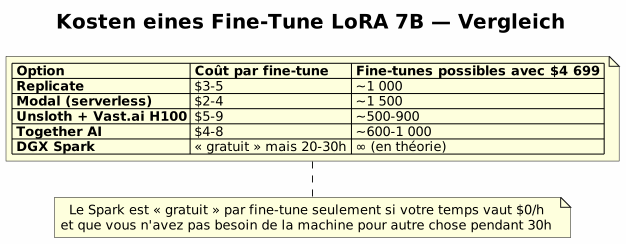
Ein Feintuning LoRA/QLoRA auf Unsloth eines 7B-Modells :
-
~2-3h auf einem H100 =$5 bis $9
-
Das Gleiche auf dem Spark =20-30h(10 Mal langsamer), blockiert die Maschine
Mit den $4 699 des Spark, können Sie finanzieren :
-
~500 bis ~900 Feinabstimmungenin Cloud H100
-
Ou ungefähr 23 Jahrevon Ollama Pro
-
Ou ~4 Jahred’Ollama Max
Und für größere Modelle (70B+):
-
Le Spark avec ses 128 Go peut charger un 70B en Q4 — mais le fine-tune sera extrêmement lent
-
Un H100 avec 80 Go peut fine-tuner un 70B en QLoRA 4-bit en quelques heures
-
Für ein vollständiges Fine‑Tuning braucht man grundsätzlich mehrere GPUs — Spark ist aus dem Rennen.
Die spezialisierten Akteure
Im Jahr 2026 bieten Plattformen wie Unsloth, Modal, Replicate und Together AI serverloses Feintuning an:
-
Keine GPU-Verwaltung
-
Keine Umgebungskonfiguration
-
Zahlung pro Minute
-
integrierte Optimierungen (Flash Attention, automatische Quantisierung)
Der einzige wahre Grund: Die Souveränität der Daten
Nachdem die Inferenz, das Fine‑Tuning und das Preis‑leistungs‑Verhältnis eliminiert wurden — was bleibt noch für Spark?
Absolute Vertraulichkeit
Es geht nicht um den Datenschutz: „Ich möchte nicht, dass meine Prompts von einem OpenAI‑Mitarbeiter gelesen werden“. Das ist im Jahr 2026 ein falsches Problem: Ollama, Groq und die meisten seriösen Anbieter haben Richtlinien ohne Logging und ohne Aufbewahrung.
Echte Vertraulichkeit ist:
-
Regulatorischer Luftabstand: Verteidigung, Diplomatie, Gesundheit — Daten können physisch das Gebäude nicht verlassen
-
Kritische proprietäre Daten: Quellcode eines unveröffentlichten Produkts, Geschäftsgeheimnisse, Handelsalgorithmen
-
NetzwerkresilienzDie KI muss weiterlaufen, selbst wenn das Internet ausfällt
|
Aber seien wir ehrlich: Welcher Prozentsatz der Käufer von DGX Spark ist tatsächlich in diesem Fall? 1 %? Der Rest ist ein „nice to have“, das in eine Ausgabe von 4 699 $ umgewandelt wurde. |
Die wahre Berechnung der Vertraulichkeit
Für den individuellen Gebrauch:
-
Ollama Pro($20/Monat) + chinesische Open-Source-Modelle = pragmatische Lösung
-
Wenn ein Prompt bei Ollama austritt, versinkt er in den Millionen täglicher Anfragen. Das ist ein Tropfen im Ozean.
-
Das wahre Risiko besteht nicht im Auslaufen eines Prompts — es ist das Training ohne Einwilligung an Ihren Daten. Und das verbieten ernsthafte Provider vertraglich.
import sys
def main(): data = sys.stdin.read() if data == "": print("", end="") return
tokens = data.split(‘') n = len(tokens) parts = [] for i in range(n): parts.append(tokens[i]) if i < n - 1: parts.append('’)
print(''.join(parts), end="")
if name == 'main': main()
Zusammenfassung: Die Entscheidungsmatrix
Kriterium |
Ollama kostenlos |
Ollama Pro |
Cloud GPU H100 |
DGX Spark |
Inferenz |
beschränkt |
✅ Bequem |
✅ Übertreibung |
⚠️ Langsam |
Feinabstimmung |
�❌ |
❌ |
�✅ unbesiegbar |
⚠️ Möglich aber langsam |
Jahreskosten |
$0 |
$200 |
Variable (~$416-2 080*) |
$4 699 im Voraus |
Vertraulichkeit |
⚠️ Cloud US |
�⚠️ Wolke USA |
Cloud US (variabel) |
✅ Total |
Wartung |
keine |
Keine |
einzigartige Einrichtung |
Elektrizität, Updates |
Obsoleszenz |
Keine |
keine |
Keine |
3-5 Jahre |
Software-Ökosystem |
Alle Modelle offen |
Alle Modelle open |
Alle Modelle open |
CUDA (langsamer) |
Urteil |
gelegentlich |
Empfohlen |
Vorteile/Suche |
Nur Air-gap |
*Variabel gemäß Arbeitsaufwand ; mit H100-Geschwindigkeit ~10x > Spark, die effektiven Kosten für einen gegebenen Workload sind niedrig.
Der Sonderfall: Das Pro-Abonnement gegenüber den chinesischen Modellen
Ein Punkt ist hervorzuheben: die KombinationOllama Pro zu $20/Monat + chinesische Open-Source-ModelleEs ist wahrscheinlich das beste Preis‑Leistungs‑Verhältnis in der Geschichte der KI für den Massenmarkt.
Warum ändern chinesische Modelle alles
-
DeepSeek-V4-Pro: 1.6T Parameter, CSA+HCA, 1M Kontext, wettbewerbsfähig mit Claude 4 und GPT-5 für Code
-
Qwen-3: 235B, 256K Kontext, ausgezeichnet auf Französisch und im Denken
-
GLM-5.1: 744B, MLA+DSA, 200K Kontext, maßgeschneidert für Agentik
Alle verfügbar bei Ollama. Alle Open‑Source (permissive Lizenzen). Alle ohne Einschränkung nutzbar über ein Abonnement von 20 $/Monat.
|
Mit Ollama Pro hast du Zugriff auf etwa fünf « frontier » Open-Source-Modelle zum Preis eines einzigen geschlossenen Modells (Claude Pro). Der Wert ist so asymmetrisch, dass es fast absurd wird. |
Was das für die Hardware bedeutet
Wenn das beste Preis-Leistungs-Verhältnis ein Cloud-Abonnement zu $20 pro Monat ist, wird die lokale Hardware zu einer Frage des Komforts oder des Prinzips — nicht einer wirtschaftlichen Entscheidung.
Ein DGX Spark zu $4 699 ist das Äquivalent von:
-
235 Monate Ollama Pro
-
Veröffentlichungsdatum für 23 AAA‑Spiele
-
4 MacBook Air M4
-
Ein Jahr Miete einer Zweizimmerwohnung in Lyon
Für die Berechnung. Langsam.
Und Huawei?
Da die Frage mir während meiner Recherche gestellt wurde: Nein, Huawei vertreibt kein Äquivalent zum DGX Spark.
Was existiert :
-
Ascend 910C : 128 Go HBM, 800 TFLOPS FP16 — mais c’est une puce serveur, pas un desktop
-
Atlas 300I Duo : 96 Go LPDDR4X, carte PCIe à ~$1 400 — nécessite un hôte
-
Atlas 350 : 112 Go HBM, 1.56 PFLOPS FP4 — accélérateur datacenter, pas un boîtier compact
Huawei reste focalisé sur le marché des serveurs et des centres de données. Pour un boîtier compact « prêt à brancher » avec 120+ Go de VRAM, le DGX Spark (128 Go unifié) et le Mac Studio M3 Ultra (192 Go unifié) sont les seules options en 2026. Et pour l’instant, aucun constructeur chinois n’a annoncé de produit équivalent dans ce format.
Fazit: Der Luxus der Nähe
Das DGX Spark ist kein schlechtes Produkt. Es ist eine schlechte Investition für 99% der potenziellen Käufer.
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 10) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Die KI-Landschaft 2026 — Wer dominiert?
left to right direction

package "Privater Gebrauch / KMU" #C8E6C9 {
  rectangle "🏆 Ollama Pro\n$20/Monat" as pro
  rectangle "Ollama Free
^^^^^
 Syntax Error? (Assumed diagram type: component)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Die KI-Landschaft 2026 — Wer dominiert?
left to right direction

package "Privater Gebrauch / KMU" #C8E6C9 {
  rectangle "🏆 Ollama Pro\n$20/Monat" as pro
  rectangle "Ollama Free
$0/Monat" as free
  rectangle "Cloud GPU-Spot
$1-3/h" as spot
}

package "Intensive Nutzung / Pro" #FFF9C4 {
  rectangle "�🏆 Ollama Max
$100/Monat" as max
  rectangle "Dedizierte Cloud-GPU
$2-4/h" as dedicated
  rectangle "Modal / Together AI
Serverless" as serverless
}

package "obligatorischer Luftspalt" #FFCDD2 {
  rectangle "DGX Spark
$4 699" as spark
  rectangle "Mac Studio M3U
~$5 000" as mac
}

note bottom of spark
  1% des cas d'usage — défense,
  santé réglementée, secrets
  industriels critiques
end note

@enduml
__ Ein DGX Spark aus 2026 zu kaufen, ist wie ein Mailserver aus 2010 zu kaufen: technisch möglich, philosophisch befriedigend, wirtschaftlich absurd für eine Person. (Empty)
Die Rechnung ist einfach, und sie lügt nicht:
-
$0um mit DeepSeek auf Ollama Free zu chatten
-
$200/Jahrum ernsthaft mit Ollama Pro zu arbeiten
-
$5-9für ein einmaliges Fine-Tuning auf Cloud-GPU
-
$4.699für… das Erlebnis, ein NVIDIA-Gehäuse auf seinem Schreibtisch zu haben ?
Der Markt hat entschieden. Cloud-Abonnements und chinesische Open-Source-Modelle haben die Preisschlacht gewonnen. Lokale Hardware überlebt nur in regulatorischen Nischen, nicht in den Büros der Entwickler.
_ Der DGX Spark ist kein kosteneffizientes Werkzeug. Es ist ein Statement. « Ich möchte meine KI zu Hause haben, nicht in der Cloud eines anderen. » Das ist respektabel. Aber 2026, wenn Ollama dir DeepSeek-V4-Pro in der Cloud für $20/Monat gibt, ist das vor allem ein Statement, das sehr teuer ist. _
Dieser Artikel stammt aus einem Gespräch mit meinem KI-Agenten über die wirtschaftliche Relevanz des DGX Spark, abgeglichen mit einer Marktbeobachtung zu den Cloud-GPU-Preisen (Vast.ai, RunPod), den Preismodellen von Ollama/Claude und dem Ökosystem chinesischer Open-Source-Modelle. Die genannten Preise stammen aus Mai 2026 – sie werden wahrscheinlich noch weiter gefallen sein, wenn Sie diese Zeilen lesen.