DGX Spark vs Cloud vs Abonnements LLM — El Benchmark Económico Que Mata el Sueño del Hardware Local
Publié le 06 May 2026
- El Contexto: Un Mercado Que Ha Basculé
- El Panel de las Opciones
- Inferencia simple: La muerte del hardware local
- Fine-Tuning : el cloud es imbatible
- La Única Verdadera Razón: La Soberanía de los Datos
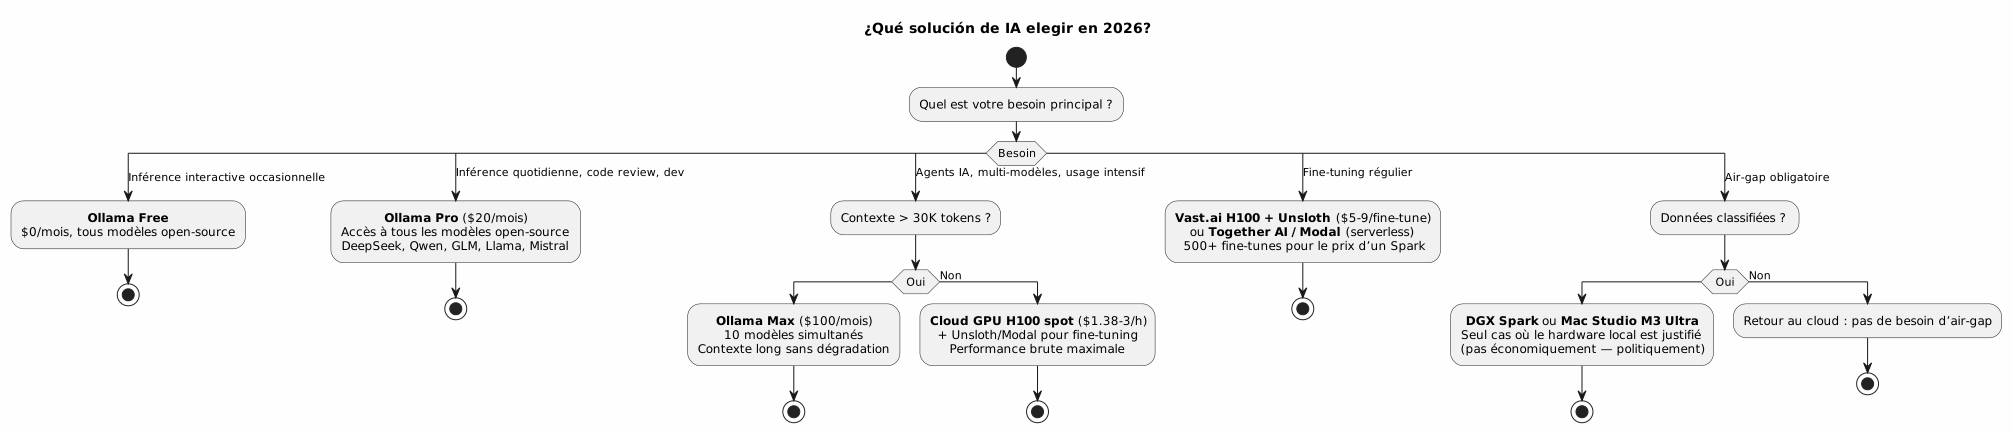
- Síntesis : La Matriz de Decisión
- El Caso Particular: La Suscripción Pro Ante los Modelos Chinos
- Y Huawei?
- Conclusión: El lujo de la proximidad
NVIDIA vende el DGX Spark como un « supercomputador IA de escritorio » a $4 699. Ollama ofrece sus modelos en la nube a $20/mes. Un H100 se alquila a $1.38/h en Vast.ai. Y los modelos de código abierto chinos — DeepSeek, Qwen, GLM — están disponibles en todas partes, gratuitamente, sin tener que comprar una tarjeta. Entonces, ¿para qué sirve exactamente este Spark? Hice los cálculos.
- TOC
-
[]
El Contexto: Un Mercado Que Ha Basculé
En mayo de 2026, el panorama de la IA cambió radicalmente respecto al anuncio del DGX Spark en el CES 2025. Tres fuerzas convergieron para hacer que el hardware local sea cada vez más difícil de justificar:
-
El colapso de los precios del cloud GPU: un H100 se alquila entre $1.38 y $3/h, frente a $5-8/h hace 18 meses
-
La explosión de los modelos chinos de código abierto: DeepSeek-V4, Qwen-3, GLM-5 son competitivos con los modelos occidentales, disponibles gratuitamente
-
El aumento de las plataformas de inferencia gestionada: Ollama, Groq, Together AI ofrecen API a precios agresivos, con niveles gratuitos generosos
El DGX Spark, anunciado a $2 999 y luego aumentado a $4 699, llega a un mundo que ya no lo necesita.
El Panel de las Opciones
Estas son las soluciones disponibles en mayo de 2026 para ejecutar LLMs, de la más ligera a la más pesada:
Opción |
Costo |
VRAM / Capacidad |
Modelos accesibles |
restricción principal |
Ollama gratis |
$0/mes |
Nube ligera |
Todos los modelos públicos |
Uso limitado, 1 modelo simultáneo |
Claude Pro |
$20/mes (~$240/año) |
N/A (API cerrada) |
Sólo Claude 4.x |
Modelo único, no es open-source |
Ollama Pro |
$20/mes (~$200/año) |
Medio en la nube |
Todos los modelos públicos |
3 modelos simultáneos máximo |
Ollama Max |
$100/mes (~$1 200/año) |
Nube pesada |
Todos los modelos públicos |
10 modelos simultáneos |
GPU en la nube (H100) |
$1.38-3/h |
80 Go HBM |
Todos los modelos, fine-tuning |
Facturación por hora, configuración requerida |
DGX Spark |
$4 699 (compra) |
128 Go unifié |
Tous modèles <128 Go |
Lento (~10x menos que un H100), fijo |
Mac Studio M3 Ultra |
~$5 000+ |
192 Go unifié |
Tous modèles <192 Go |
No CUDA, ecosistema MLX |
|
Los precios de GPU en la nube citados son los de Vast.ai y RunPod en mayo de 2026 — spot/on-demand, no reservado. Los precios de los hiperescaladores (AWS, GCP, Azure) siguen siendo 2-3 veces más altos. |
lo que he excluido (y por qué)
He excluido deliberadamente las siguientes opciones de este benchmark:
-
API OpenAI / Anthropic / Google: el tema aquí es hacer funcionar modelos open-source que se pueden elegir, ajustar, y no depender de un solo proveedor
-
Huawei Ascend / Atlas : Huawei ne commercialise pas d’équivalent desktop au DGX Spark. La gamme Ascend (910C, 910D) et Atlas (300I Duo, 350) est orientée datacenter — cartes PCIe, serveurs rack — pas des boîtiers compacts prêts à brancher. La puce Ascend 910C embarque 128 Go HBM mais c’est une puce serveur, pas un système autonome. L’Atlas 300I Duo offre 96 Go pour ~$1 400 mais nécessite une machine hôte
Inferencia simple: La muerte del hardware local
Comencemos por el caso de uso más común: chatear con un LLM, hacer una revisión de código, generar texto. No hay fine-tuning, no hay batch processing, solo inferencia interactiva.
El cálculo
Un DGX Spark a $4,699. Dividamos por el costo anual de cada suscripción:
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 7) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Umbral de Rentabilidad — DGX Spark ($4 699) vs Suscripciones
rectangle "DGX Spark
$4 699" as spark #FFCDD2
^^^^^
 Syntax Error? (Assumed diagram type: activity)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Umbral de Rentabilidad — DGX Spark ($4 699) vs Suscripciones
rectangle "DGX Spark
$4 699" as spark #FFCDD2

rectangle "Ollama Pro
$200/a" as opro #C8E6C9
rectangle "Claude Pro
$240/año" as cpro #C8E6C9
rectangle "Ollama Max
$1.200/año" as omax #FFF9C4
rectangle "Cloud H100
$3/h × 10h/semana" as cloud #BBDEFB

spark --> opro : 23.5 années ⏳
spark --> cpro : 19.6 années ⏳
spark --> omax : 3.9 années
spark --> cloud : 3.0 années (à 10h/semaine, intermittent)

note bottom of spark
  Sans compter l'électricité (~$150/an)
  Sans compter l'obsolescence hardware
  Sans compter qu'il est 10x plus lent
end note

@enduml
El veredicto es brutal. Para la inferencia :
-
Ollama Pro: necesitarías23 añospara amortizar un DGX Spark. El Spark será obsoleto desde hace 20 años.
-
Ollama Max:4 años— a condición de usar el Spark 24/7, lo que nadie hace
-
Claude Pro: mismo problema,20 añospara el single-model cerrado
(Empty output) La promesa del « supercomputador de IA de escritorio » se encuentra con una realidad contable elemental: $4 699 / $20 por mes = nunca rentable para un uso individual. (blank)
Incluso con un Uso Intensivo
Tomemos el peor escenario para la nube: ejecutas un H100 8 h/día, 5 días/semana, 52 semanas/año.
-
8 × 5 × 52 = 2 080 horas/año
-
2 080 × $2/h (precio medio spot H100) =$4.160/año
El Spark ($4 699) se amortiza en13 meses. Excepto que :
-
El H100 es~10x más rápidoque el GB10 de Spark. Usted hace en 1h lo que Spark hace en 10h. Para el mismo volumen de trabajo, el H100 le cuesta $416/año, no $4 160.
-
Le H100 a 80 Go HBM à 3.35 To/s de bande passante. Le Spark a 128 Go LPDDR5X à 273 Go/s. Pour les gros modèles, la bande passante compte plus que la capacité.
|
Comparar 1h de H100 con 1h de Spark no tiene sentido. El H100 hace el trabajo 10x más rápido. El verdadero costo en la nube para una carga de trabajo dada es, por lo tanto, ~10x inferior al cálculo ingenuo basado en las horas. |
Fine-Tuning : el cloud es imbatible
El argumento clásico de los defensores de Spark : «sí, pero para el fine-tuning es diferente
No, no lo es.
El Costo Real de un Fine-Tune
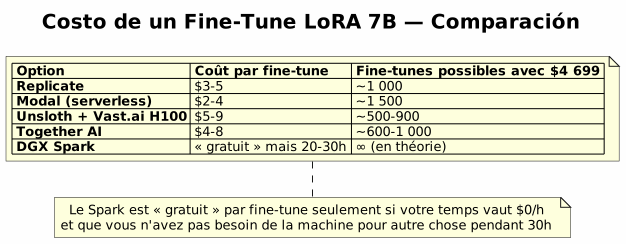
Un fine-tune LoRA/QLoRA sobre Unsloth de un modelo 7B :
-
~2-3h en un H100 =de $5 a $9
-
Lo mismo en el Spark =20-30h(10x más lento), bloquea la máquina
Con los $4 699 de Spark, puedes financiar:
-
~500 a ~900 fine-tunesen la nube H100
-
Ou ~23 añosde Ollama Pro
-
Ou ~4 añosde Ollama Max
Y para modelos más grandes (70B+):
-
Le Spark avec ses 128 Go peut charger un 70B en Q4 — mais le fine-tune sera extrêmement lent
-
Un H100 avec 80 Go peut fine-tuner un 70B en QLoRA 4-bit en quelques heures
-
Para hacer fine-tuning completo, se necesita multi-GPU de todas formas — Spark está descartado.
Los Actores Especializados
En 2026, plataformas como Unsloth, Modal, Replicate y Together AI ofrecen fine-tuning serverless:
-
Sin gestión de GPU
-
No hay configuración de entorno
-
Pago por minuto
-
Optimizaciones integradas (atención flash, cuantización automática)
La Única Verdadera Razón: La Soberanía de los Datos
Tras eliminar la inferencia, el ajuste fino y la relación calidad/precio — ¿qué queda al Spark?
La confidencialidad absoluta.
No es cuestión de confidencialidad «Je ne veux pas que mes prompts soient lus par un employé d’OpenAI». Es un problema inexistente en 2026: Ollama, Groq y la mayoría de los proveedores respetables tienen políticas de cero registro y cero retención.
La verdadera confidencialidad es:
-
Hueco de aire reglamentario: defensa, diplomacia, salud — los datos no pueden físicamente salir del edificio
-
Datos propietarios críticos: código fuente de un producto no publicado, secretos industriales, algoritmos de trading
-
Resiliencia de red: la IA debe continuar funcionando incluso si Internet cae
|
Pero seamos honestos: ¿qué porcentaje de los compradores de DGX Spark está realmente en este caso? ¿1%? El resto, es un «nice to have» convertido en un gasto de $4 699. |
El verdadero cálculo de la confidencialidad
Para uso individual :
-
Ollama Pro($20/mes) + modelos de código abierto chinos = solución pragmática
-
Si un prompt se filtra en Ollama, se pierde entre los millones de solicitudes diarias. Es una gota de agua en el océano.
-
El riesgo real no es la fuga de un prompt — es el entrenamiento no consentido en tus datos. Y eso, los proveedores serios lo prohíben contractualmente.
_ El miedo a « destilar su prompt en el LLM » es un nivel de propagación de información personal tan diluido que corresponde más a la ansiedad que a una amenaza real. A escala industrial, es diferente. Pero a escala individual, es ruido. _
Síntesis : La Matriz de Decisión
Criterio |
Ollama Gratis |
Ollama Pro |
GPU en la nube H100 |
DGX Spark |
Inferencia |
�✅ Limitada |
✅ Cómodo |
✅ Overkill |
⚠️ lento |
Ajuste fino |
�❌ |
❌ |
✅ Imbatible |
⚠️ Posible pero lento |
Costo anual |
$0 |
$200 |
Variable (~$416-2 080*) |
$4 699 por adelantado |
Confidencialidad |
�⚠️ Cloud US |
�⚠️ Cloud US |
nube EE.UU. (variable) |
✅ Total |
Mantenimiento |
Ninguna |
ninguna |
Setup único |
Electricidad, actualizaciones |
Obsolescencia |
Ninguna |
ninguna |
ninguna |
3-5 años |
Ecosistema de software |
Todos los modelos abiertos |
Todos los modelos open |
Todos los modelos open |
CUDA (pero más lento) |
veredicto |
Ocasional |
Recomendado |
Pros/Búsqueda |
Solo air-gap |
*Variable según volumen de trabajo ; con velocidad H100 ~10x > Spark, el costo efectivo para una carga de trabajo determinada es bajo.*
El Caso Particular: La Suscripción Pro Ante los Modelos Chinos
Un punto merece ser destacado : la combinaciónOllama Pro a $20/mes + modelos chinos de código abiertoprobablemente es la mejor relación calidad-precio de la historia de la IA para el gran público.
Por qué los modelos chinos cambian todo
-
DeepSeek-V4-Pro: 1.6T parámetros, CSA+HCA, 1M de contexto, competitivo con Claude 4 y GPT-5 para el código
-
Qwen-3: 235B, 256K contexto, excelente en francés y en razonamiento
-
GLM-5.1: 744B, MLA+DSA, 200K contexto, adaptado para agentes
Todos disponibles en Ollama. Todos open-source (licencias permisivas). Todos utilizables sin restricción mediante una suscripción de $20/mes.
|
Con Ollama Pro, tienes acceso a ~5 modelos « frontier » de código abierto por el precio de un solo modelo cerrado (Claude Pro). El valor es tan asimétrico que casi se vuelve absurdo. |
lo que eso significa para el hardware
Si la mejor relación calidad-precio es una suscripción en la nube de $20 al mes, el hardware local se convierte en una opción de confort o de principe — no una opción económica.
Un DGX Spark a $4.699, es equivalente a:
-
235 meses de Ollama Pro
-
23 juegos AAA día de lanzamiento
-
4 MacBook Air M4
-
Un año de alquiler de un T2 en Lyon
Para cálculo. Lento.
Y Huawei?
Puesto que la pregunta me fue planteada durante mis investigaciones : no, Huawei no comercializa un equivalente al DGX Spark.
Lo que existe:
-
Ascend 910C : 128 Go HBM, 800 TFLOPS FP16 — mais c’est une puce serveur, pas un desktop
-
Atlas 300I Duo : 96 Go LPDDR4X, carte PCIe à ~$1 400 — nécessite un hôte
-
Atlas 350 : 112 Go HBM, 1.56 PFLOPS FP4 — accélérateur datacenter, pas un boîtier compact
Huawei reste focalisé sur le marché des serveurs et des centres de données. Pour un boîtier compact « prêt à brancher » avec 120+ Go de VRAM, le DGX Spark (128 Go unifié) et le Mac Studio M3 Ultra (192 Go unifié) sont les seules options en 2026. Et pour l’instant, aucun constructeur chinois n’a annoncé de produit équivalent dans ce format.
Conclusión: El lujo de la proximidad
El DGX Spark no es un mal producto. Es una mala inversión para el 99% de los compradores potenciales.
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 9) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title El panorama IA en 2026 — ¿Quién domina?
left to right direction

package "Uso Personal / PYME" #C8E6C9 {
  rectangle "�🏆 Ollama Pro
^^^^^
 Syntax Error? (Assumed diagram type: class)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title El panorama IA en 2026 — ¿Quién domina?
left to right direction

package "Uso Personal / PYME" #C8E6C9 {
  rectangle "�🏆 Ollama Pro
$20/mes" as pro
  rectangle "Ollama Gratis
$0/mes" as free
  rectangle "Instancia de GPU spot en la nube
$1-3/h" as spot
}

package "Uso Intensivo / Pro" #FFF9C4 {
  rectangle "🏆 Ollama Max
$100/mes" as max
  rectangle "�🏆 Cloud GPU dedicado\n$2-4/h" as dedicated
  rectangle "Modal / Together AI\nServerless" as serverless
}

package "Air-Gap Obligatorio" #FFCDD2 {
  rectangle "DGX Spark
$4 699" as spark
  rectangle "Mac Studio M3U
~$5 000" as mac
}

note bottom of spark
  1% des cas d'usage — défense,
  santé réglementée, secrets
  industriels critiques
end note

@enduml
__ Comprar un DGX Spark en 2026 es como comprar un servidor de correo en 2010: técnicamente posible, filosóficamente satisfactorio, económicamente absurdo para un individuo. </think> </think>
El cálculo es sencillo, y no miente :
-
$0para chatear con DeepSeek en Ollama Free
-
$200/añopara trabajar seriamente con Ollama Pro
-
$5-9para un fine-tune puntual en GPU en la nube
-
$4 699¿… la experiencia de tener una caja NVIDIA en su escritorio?
El mercado ha decidido. Las suscripciones cloud y los modelos open-source chinos han ganado la batalla del precio. El hardware local sobrevive en los nichos regulatorios, no en las oficinas de los desarrolladores.
_ El DGX Spark no es una herramienta rentable. Es un statement. « Quiero mi IA en casa, no en el cloud de otra persona. » Es respetable. Pero en 2026, cuando Ollama te da DeepSeek-V4-Pro en la nube por $20/mes, principalmente es un statement que cuesta muy caro. _
Este artículo proviene de una conversación con mi agente IA sobre la relevancia económica del DGX Spark, cruzada con una vigilancia de mercado sobre los precios de GPU en la nube (Vast.ai, RunPod), las tarifas de Ollama/Claude, y el ecosistema de los modelos chinos de código abierto. Los precios citados son los de mayo de 2026 — probablemente habrán bajado aún más cuando leas estas líneas.