DGX Spark vs Cloud vs Assinaturas de LLM — O Benchmark Econômico que mata o sonho do hardware local
Publié le 06 May 2026
- O Contexto : Um Mercado que Invertiu
- Painel das Opções
- Inferência Simples: A Morte do Hardware Local
- Fine-Tuning : O Cloud é invencível
- A única verdadeira razão: a soberania dos dados
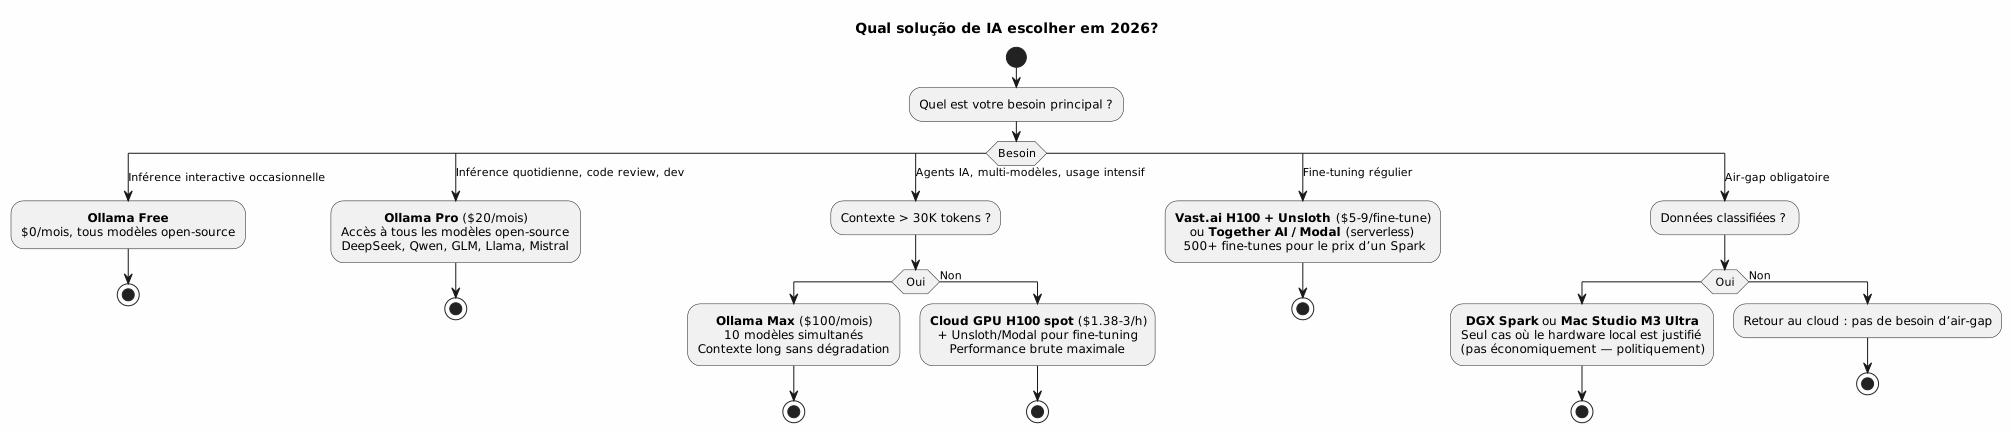
- Síntese: A matriz de decisão
- O Caso Particular: A Assinatura Pro Face aos Modelos Chineses
- E Huawei?
- Conclusão: O Luxo da Proximidade
NVIDIA vende o DGX Spark como um « supercomputador IA de mesa » por $4 699. A Ollama oferece seus modelos na nuvem por $20/mês. Um H100 pode ser alugado por $1,38/h na Vast.ai. E os modelos chineses de código aberto — DeepSeek, Qwen, GLM — estão disponíveis em todo lugar, gratuitamente, sem precisar comprar uma placa. Então, para que serve esse Spark exatamente? Fiz as contas.
- toc
-
[]
O Contexto : Um Mercado que Invertiu
Em maio de 2026, o cenário da IA mudou radicalmente em relação ao anúncio do DGX Spark na CES 2025. Três forças convergiram para tornar o hardware local cada vez mais difícil de justificar:
-
O colapso dos preços do cloud GPU: um H100 é alugado entre $1.38 e $3/h, versus $5-8/h há 18 meses
-
A explosão dos modelos chineses open-sourceDeepSeek-V4, Qwen-3, GLM-5 são competitivos com os modelos ocidentais, disponíveis gratuitamente
-
A ascensão das plataformas de inferência gerenciadaOllama, Groq, Together AI oferecem APIs com tarifas agressivas, com camadas gratuitas generosas
O DGX Spark, anunciado a $2 999 e depois elevado a $4 699, chega a um mundo que não precisa mais dele.
Painel das Opções
Aqui estão as soluções disponíveis em maio de 2026 para rodar os LLMs, da mais leve à mais pesada:
opção |
Custo |
VRAM / Capacidade |
Modelos acessíveis |
Restrição principal |
Ollama Gratuito |
$0/mês |
nuvem leve |
Todos modelos públicos |
Uso limitado, 1 modelo simultâneo |
Claude Pro |
$20/mês (~$240/ano) |
N/A (API fechada) |
Claude 4.x apenas |
Modelo único, não é open-source |
Ollama Pro |
$20/mês (~$200/ano) |
Meio de nuvem |
Todos os modelos públicos |
3 modelos simultâneos máximo |
Ollama Max |
$100/mês (~$1 200/ano) |
nuvem pesada |
Todos os modelos públicos |
10 modelos simultâneos |
GPU de nuvem (H100) |
$1.38-3/h |
80 Go HBM |
Todos os modelos, ajuste fino |
Faturação horária, configuração necessária |
DGX Spark |
$4 699 (compra) |
128 Go unifié |
Tous modèles <128 Go |
Lento (~10x menos que um H100), fixo |
Mac Studio M3 Ultra |
~$5 000+ |
192 Go unifié |
Tous modèles <192 Go |
Não CUDA, ecossistema MLX |
|
Os preços de GPU na nuvem citados são os da Vast.ai e do RunPod em maio de 2026 — spot/on-demand, não reservado. Os preços dos hyperscalers (AWS, GCP, Azure) permanecem 2-3x mais altos. |
O que excluí (e por que)
Excluí intencionalmente as seguintes opções deste benchmark:
-
API OpenAI / Anthropic / Google: o assunto aqui é fazer rodar modelos open-source que podemos escolher, ajustar finamente, e não depender de um único fornecedor
-
Huawei Ascend / Atlas : Huawei ne commercialise pas d’équivalent desktop au DGX Spark. La gamme Ascend (910C, 910D) et Atlas (300I Duo, 350) est orientée datacenter — cartes PCIe, serveurs rack — pas des boîtiers compacts prêts à brancher. La puce Ascend 910C embarque 128 Go HBM mais c’est une puce serveur, pas un système autonome. L’Atlas 300I Duo offre 96 Go pour ~$1 400 mais nécessite une machine hôte
Inferência Simples: A Morte do Hardware Local
Começamos pelo caso de uso mais comum: conversar com um LLM, fazer revisão de código, gerar texto. Sem fine-tuning, sem processamento em lote, apenas inferência interativa.
O Cálculo
Um DGX Spark por $4.699. Dividamos pelo custo anual de cada assinatura:
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 7) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Ponto de Equilíbrio — DGX Spark ($4 699) vs Assinaturas
rectangle "DGX Spark
$4 699" as spark #FFCDD2
^^^^^
 Syntax Error? (Assumed diagram type: activity)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Ponto de Equilíbrio — DGX Spark ($4 699) vs Assinaturas
rectangle "DGX Spark
$4 699" as spark #FFCDD2

rectangle "Ollama Pro
$200/ano" as opro #C8E6C9
rectangle "Claude Pro
$240/ano" as cpro #C8E6C9
rectangle "Ollama Max
$1 200/ano" as omax #FFF9C4
rectangle "Cloud H100\n$3/h × 10h/sem" as cloud #BBDEFB

spark --> opro : 23.5 années ⏳
spark --> cpro : 19.6 années ⏳
spark --> omax : 3.9 années
spark --> cloud : 3.0 années (à 10h/semaine, intermittent)

note bottom of spark
  Sans compter l'électricité (~$150/an)
  Sans compter l'obsolescence hardware
  Sans compter qu'il est 10x plus lent
end note

@enduml
O veredicto é brutal. Para inferência :
-
Ollama Pro: você precisaria23 anospara amortizar um DGX Spark. O Spark estará obsoleto há 20 anos.
-
Ollama Max:4 anos— desde que se utilize o Spark 24/7, o que ninguém faz
-
Claude Pro: mesmo problema,20 anospara o single-model fechado
_ A promessa do « supercomputador IA de mesa » esbarra numa realidade contábil elementar : $4 699 / $20 por mês = nunca rentável para uso individual. _
Mesmo com uso intensivo
Consideremos o pior cenário para a nuvem: você executa um H100 8h/dia, 5 dias/semana, 52 semanas/ano.
-
8 × 5 × 52 = 2 080 horas/ano
-
2 080 × $2/h (preço médio spot H100) =$4 160/ano
O Spark ($4 699) é amortizado em13 meses. Mas :
-
O H100 é~10x mais rápidoque o GB10 do Spark. Você faz em 1h o que o Spark faz em 10h. Para o mesmo volume de trabalho, o H100 custa $416/ano, não $4 160.
-
Le H100 a 80 Go HBM à 3.35 To/s de bande passante. Le Spark a 128 Go LPDDR5X à 273 Go/s. Pour les gros modèles, la bande passante compte plus que la capacité.
|
Comparar 1h de H100 a 1h de Spark não faz sentido. O H100 faz o trabalho 10x mais rápido. O verdadeiro custo na nuvem para uma carga de trabalho dada é portanto ~10x inferior ao cálculo ingênuo baseado nas horas. |
Fine-Tuning : O Cloud é invencível
O argumento clássico dos defensores do Spark : « sim mas para o fine-tuning, é diferente ».
Não, isso não é.
O custo real de um Fine-Tune
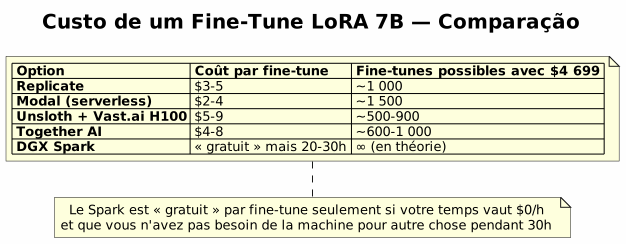
Um fine-tune LoRA/QLoRA no Unsloth de um modelo 7B :
-
~2-3h em um H100 =$5 a $9
-
Mesma coisa no Spark =20-30h(10 vezes mais lento), bloqueia a máquina
Com os $4 699 do Spark, você pode financer:
-
~500 a ~900 fine-tunesem cloud H100
-
Ou ~23 anosde Ollama Pro
-
Ou ~4 anosde Ollama Max
E para modelos maiores (70B+) :
-
Le Spark avec ses 128 Go peut charger un 70B en Q4 — mais le fine-tune sera extrêmement lent
-
Un H100 avec 80 Go peut fine-tuner un 70B en QLoRA 4-bit en quelques heures
-
Para um fine-tune completo, é preciso multi-GPU de qualquer forma — o Spark está fora da corrida
Os Atores Especializados
Em 2026, plataformas como Unsloth, Modal, Replicate e Together AI oferecem fine-tuning serverless :
-
Sem gestão de GPU
-
Sem configuração de ambiente
-
Pagamento por minuto
-
Otimizações integradas (flash attention, quantização automática)
A única verdadeira razão: a soberania dos dados
Depois de eliminar a inferência, o fine-tuning, e a relação custo-benefício — o que resta ao Spark ?
A confidencialidade absoluta.
Não é sobre privacidade «não quero que meus prompts sejam lidos por um funcionário da OpenAI». Isso, isso é um problema falso em 2026: Ollama, Groq e a maioria dos provedores respeitáveis têm políticas de zero logs e zero retenção.
A verdadeira confidencialidade é:
-
Air gap regulamentar: defesa, diplomacia, saúde — os dados não podem fisicamente sair do prédio
-
Dados proprietários críticos: código-fonte de um produto não publicado, segredos industriais, algoritmos de negociação
-
Resiliência rede: a IA deve continuar a funcionar mesmo se a Internet cai
|
Mas sejamos honestos: qual a porcentagem dos compradores do DGX Spark que realmente se enquadram nesse caso? 1%? O resto é um « nice to have » transformado em uma despesa de $4 699. |
O Verdadeiro Cálculo da Confidencialidade
Para uso individual:
-
Ollama Pro($20/mês) + modelos de código aberto chineses = solução pragmática
-
Se um prompt vazar no Ollama, ele se perde nos milhões de solicitações diárias. É uma gota d’água no oceano.
-
O risco real não é a fuga de um prompt — é o treinamento não consentido nos seus dados. E isso, os fornecedores sérios o proíbem contractualmente.
_ O medo de « distillar seu prompt no LLM » é um nível de propagação de informação pessoal tão diluído que se encaixa mais na ansiedade do que na ameaça real. Em escala industrial, é diferente. Mas em escala individual, é ruído. _
Síntese: A matriz de decisão
Critério |
Ollama Livre |
Ollama Pro |
GPU H100 na nuvem |
DGX Spark |
Inferência |
�✅ limitada |
✅ confortável |
�✅ Exagero |
⚠️ Lento |
ajuste fino |
�❌ |
�❌ |
�✅ Invencível |
�⚠️ Possível mas lento |
Custo anual |
$0 |
$200 |
Variável (~$416-2 080*) |
$4 699 adiantado |
Confidencialidade |
�⚠️ Nuvem EUA |
�⚠️ Nuvem EUA |
⚠️ Nuvem EUA (variável) |
✅ Total |
Manutenção |
Nenhuma |
Nenhuma |
Configuração única |
Eletricidade, atualizações |
Obsolescência |
Nenhuma |
Nenhuma |
nenhuma |
3-5 anos |
Ecossistema de software |
Todos os modelos abertos |
Todos os modelos open |
Todos modelos open |
CUDA (mais lento) |
veredicto |
ocasional |
Recomendado |
prós/pesquisa |
Somente air-gap |
*Variável conforme volume de trabalho ; com velocidade H100 ~10x > Spark, o custo efetivo para uma carga de trabalho determinada é baixo.
O Caso Particular: A Assinatura Pro Face aos Modelos Chineses
Um ponto merece ser destacado: a combinaçãoOllama Pro a $20/mês + modelos chineses de código abertoÉ provavelmente a melhor relação custo-benefício da história da IA para o grande público.
Por que os Modelos Chinos Mudam Tudo
-
DeepSeek-V4-Pro: 1.6T parâmetros, CSA+HCA, 1M contexto, competitivo com Claude 4 e GPT-5 para o código
-
Qwen-3: 235B, 256K contexto, excelente em francês e em raciocínio
-
GLM-5.1: 744B, MLA+DSA, 200K contexto, personalizado para o agente
Todos disponíveis no Ollama. Todos de código aberto (licenças permissivas). Todos utilizáveis sem restrição através de uma assinatura de $20/mês.
|
Com o Ollama Pro, você tem acesso a ~5 modelos « de ponta » de código aberto pelo preço de um único modelo fechado (Claude Pro). O valor é tão assimétrico que quase se torna absurdo. |
O Que Isso Significa para o Hardware
Se a melhor relação qualidade‑preço for uma assinatura na nuvem de $20 por mês, o hardware local passa a ser uma escolha de confort ou de princípio — não uma escolha econômica.
Um DGX Spark a $4 699, equivale a :
-
235 meses de Ollama Pro
-
23 jogos AAA dia de lançamento
-
4 MacBook Air M4
-
Um ano de aluguel de um T2 em Lyon
Para cálculo. Lento.
E Huawei?
Já que a pergunta me foi feita durante minhas pesquisas: não, a Huawei não comercializa um equivalente ao DGX Spark.
O que existe:
-
Ascend 910C : 128 Go HBM, 800 TFLOPS FP16 — mais c’est une puce serveur, pas un desktop
-
Atlas 300I Duo : 96 Go LPDDR4X, carte PCIe à ~$1 400 — nécessite un hôte
-
Atlas 350 : 112 Go HBM, 1.56 PFLOPS FP4 — accélérateur datacenter, pas un boîtier compact
Huawei reste focalisé sur le marché des serveurs et des centres de données. Pour un boîtier compact « prêt à brancher » avec 120+ Go de VRAM, le DGX Spark (128 Go unifié) et le Mac Studio M3 Ultra (192 Go unifié) sont les seules options en 2026. Et pour l’instant, aucun constructeur chinois n’a annoncé de produit équivalent dans ce format.
Conclusão: O Luxo da Proximidade
O DGX Spark não é um mau produto. É um mau investimento para 99% dos compradores potenciais.
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 9) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Cenário da IA em 2026 — Quem domina?
left to right direction

package "Uso Pessoal / PME" #C8E6C9 {
  rectangle "🏆 Ollama Pro
^^^^^
 Syntax Error? (Assumed diagram type: class)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Cenário da IA em 2026 — Quem domina?
left to right direction

package "Uso Pessoal / PME" #C8E6C9 {
  rectangle "🏆 Ollama Pro
$20/mês" as pro
  rectangle "Ollama Grátis
$0/mês" as free
  rectangle "Spot da GPU em nuvem
$1-3/h" as spot
}

package "Uso Intensivo / Profissional" #FFF9C4 {
  rectangle "🏆 Ollama Max
$100/mês" as max
  rectangle "�🏆 GPU de nuvem dedicado\n$2-4/h" as dedicated
  rectangle "Modal / Together AI
Serverless" as serverless
}

package "Air-Gap Obrigatório" #FFCDD2 {
  rectangle "DGX Spark
$4 699" as spark
  rectangle "Mac Studio M3U\n~$5 000" as mac
}

note bottom of spark
  1% des cas d'usage — défense,
  santé réglementée, secrets
  industriels critiques
end note

@enduml
_ Comprar um DGX Spark em 2026 é como comprar um servidor de e‑mail em 2010: tecnicamente possível, filosoficamente satisfatório, economicamente absurdo para um indivíduo. _
O cálculo é simples, e ele não mente :
-
$0para conversar com o DeepSeek no Ollama Free
-
$200/anopara trabalhar seriamente com Ollama Pro
-
$5-9para um fine-tune pontual na nuvem GPU
-
$4 699para… a experiência de ter uma caixa NVIDIA na sua secretária?
O mercado decidiu. As assinaturas em nuvem e os modelos open-source chineses venceram a batalha do preço. O hardware local sobrevive nos nichos regulatórios, não nos escritórios dos desenvolvedores.
_ O DGX Spark não é uma ferramenta rentável. É uma declaração. « Quero minha IA em casa, não na nuvem de outra pessoa. » É respeitável. Mas em 2026, quando Ollama te dá DeepSeek-V4-Pro na nuvem por $20/mês, é principalmente uma declaração que custa muito caro. _
Este artigo resulta de uma conversa com meu agente IA sobre a pertinência econômica do DGX Spark, cruzada com uma vigilância de mercado sobre os preços de GPU na nuvem (Vast.ai, RunPod), as tabelas tarifárias Ollama/Claude, e o ecossistema dos modelos chineses de código aberto. Os preços citados são de maio de 2026 — provavelmente ainda terão caído quando você ler estas linhas.