DGX Spark vs Cloud vs Abbonamenti LLM — Il Benchmark Economico Che Uccide il Sogno dell'Hardware Locale
Publié le 06 May 2026
- Il Contesto : Un Mercato Che Ha Subito Una Svolta
- Il Pannello delle Opzioni
- Inferenza semplice: La morte dell’hardware locale
- Fine-Tuning : Il Cloud è imbattibile
- L’unica vera ragione: la sovranità dei dati
- Sintesi : La Matrice di Decisione
- Il Caso Particolare: L’Abbonamento Pro di Fronte ai Modelli Cinesi
- E Huawei?
- Conclusione: Il lusso della vicinanza
NVIDIA vende il DGX Spark come un « supercomputer IA da scrivania » a $4 699. Ollama propone i suoi modelli cloud a $20/mese. Un H100 si noleggia a $1.38/h presso Vast.ai. E i modelli cinesi open-source — DeepSeek, Qwen, GLM — sono disponibili ovunque, gratuitamente, senza dover acquistare una scheda. Allora, questo Spark, a cosa serve esattamente? Ho fatto i conti.
- indice
-
[]
Il Contesto : Un Mercato Che Ha Subito Una Svolta
Nel maggio 2026, il panorama dell’IA è cambiato radicalmente rispetto all’annuncio del DGX Spark al CES 2025. Tre forze hanno convergito per rendere l’hardware locale sempre più difficile da giustificare :
-
Il crollo dei prezzi del cloud GPUUn H100 si affitta fra $1,38 e $3/ora, rispetto ai $5‑8/ora di 18 mesi fa.
-
L’esplosione dei modelli cinesi open-sourceDeepSeek‑V4, Qwen‑3, GLM‑5 sono competitivi con i modelli occidentali, disponibili gratuitamente
-
L’ascesa delle piattaforme di inferenza gestitaOllama, Groq, Together AI offrono API a tariffe aggressive, con piani gratuiti generosi
Il DGX Spark, annunciato a $2 999 e poi portato a $4 699, arriva in un mondo che non ha più bisogno di lui.
Il Pannello delle Opzioni
Ecco le soluzioni disponibili a maggio 2026 per far girare i LLM, dalla più leggera alla più pesante :
Opzione |
Costo |
VRAM / Capacità |
Modelli accessibili |
Vincolo principale |
Ollama Free |
$0/mese |
Cloud leggero |
Tutti i modelli pubblici |
Utilizzo limitato, 1 modello simultaneo |
Claude Pro |
$20/mese (~$240/anno) |
N/A (API chiusa) |
Solo Claude 4.x |
Modello unico, nessun open-source |
Ollama Pro |
$20/mese (~$200/anno) |
mezzo cloud |
Tutti i modelli pubblici |
Massimo 3 modelli simultanei |
Ollama Max |
$100/mese (~$1 200/anno) |
nuvola pesante |
Tutti i modelli pubblici |
10 modelli simultanei |
GPU cloud (H100) |
$1.38-3/h |
80 Go HBM |
Tutti i modelli, fine-tuning |
Fatturazione oraria, setup richiesto |
DGX Spark |
$4 699 (acquisto) |
128 Go unifié |
Tous modèles <128 Go |
Lento (~10x meno di un H100), fisso |
Mac Studio M3 Ultra |
~$5 000+ |
192 Go unifié |
Tous modèles <192 Go |
Non CUDA, ecosistema MLX |
|
I prezzi cloud GPU citati sono quelli di Vast.ai e RunPod a maggio 2026 — spot/on-demand, non riservato. I prezzi degli hyperscaler (AWS, GCP, Azure) rimangono 2-3 volte più alti. |
Cosa ho escluso (e perché)
Ho deliberatamente escluso le seguenti opzioni da questo benchmark:
-
API OpenAI / Anthropic / Google: l’argomento qui è far girare dei modelli open-source che si possono scegliere, fine-tunare, e non essere dipendenti da un unico fornitore
-
Huawei Ascend / Atlas : Huawei ne commercialise pas d’équivalent desktop au DGX Spark. La gamme Ascend (910C, 910D) et Atlas (300I Duo, 350) est orientée datacenter — cartes PCIe, serveurs rack — pas des boîtiers compacts prêts à brancher. La puce Ascend 910C embarque 128 Go HBM mais c’est une puce serveur, pas un système autonome. L’Atlas 300I Duo offre 96 Go pour ~$1 400 mais nécessite une machine hôte
Inferenza semplice: La morte dell’hardware locale
Partiamo dal caso d’uso più comune: chattare con un LLM, fare code review, generare testo. Nessun fine-tuning, nessun batch processing, solo inferenza interattiva.
Il Calcolo
Un DGX Spark a $4.699. Dividiamo per il costo annuale di ogni abbonamento:
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 7) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Soglia di Redditività — DGX Spark ($4 699) vs Abbonamenti
rectangle "DGX Spark
$4.699" as spark #FFCDD2
^^^^^
 Syntax Error? (Assumed diagram type: activity)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Soglia di Redditività — DGX Spark ($4 699) vs Abbonamenti
rectangle "DGX Spark
$4.699" as spark #FFCDD2

rectangle "Ollama Pro\n$200/anno" as opro #C8E6C9
rectangle "Claude Pro
$240/anno" as cpro #C8E6C9
rectangle "Ollama Max
$1 200/anno" as omax #FFF9C4
rectangle "Cloud H100
$3/h × 10h/settimana? Wait check: "10h/settimana". I wrote "10h/settimana". Yes.

So final.

</think>

Cloud H100
$3/h × 10h/settimana" as cloud #BBDEFB

spark --> opro : 23.5 années ⏳
spark --> cpro : 19.6 années ⏳
spark --> omax : 3.9 années
spark --> cloud : 3.0 années (à 10h/semaine, intermittent)

note bottom of spark
  Sans compter l'électricité (~$150/an)
  Sans compter l'obsolescence hardware
  Sans compter qu'il est 10x plus lent
end note

@enduml
Il verdetto è brutale. Per l’inferenza :
-
Ollama Pro: ti servirebbe23 anniper ammortizzare un DGX Spark. Lo Spark sarà obsoleto da 20 anni.
-
Ollama Max(No output, as the input text is empty)4 anni— a condizione di utilizzare Spark 24/7, cosa che nessuno fa
-
Claude Pro: stesso problema,20 anniper single-model chiuso
(output empty) La promessa del « supercomputer IA da scrivania » si scontra con una realtà contabile elementare : $4 699 / $20 al mese = mai redditizio per un uso individuale. (No output)
Anche con un utilizzo intensivo
Consideriamo il caso peggiore per il cloud: fai girare un H100 8h/giorno, 5 giorni/settimana, 52 settimane/anno.
-
8 × 5 × 52 = 2 080 ore/anno
-
2 080 × $2/h (prezzo medio spot H100) =$4 160/anno
Lo Spark ($4 699) si ripaga in13 mesi. Tranne che :
-
Il H100 è~10 volte più veloceche il GB10 di Spark. Fate in 1h quello che Spark fa in 10h. Per lo stesso volume di lavoro, l’H100 ti costa $416/anno, non $4 160.
-
Le H100 a 80 Go HBM à 3.35 To/s de bande passante. Le Spark a 128 Go LPDDR5X à 273 Go/s. Pour les gros modèles, la bande passante compte plus que la capacité.
|
Confrontare 1h di H100 con 1h di Spark non ha senso. L’H100 svolge il lavoro 10x più velocemente. Il vero costo cloud per un workload dato è quindi ~10x inferiore al calcolo ingenuo basato sulle ore. |
Fine-Tuning : Il Cloud è imbattibile
L’argomento classico dei difensori di Spark: « sì ma per il fine-tuning, è diverso ».
No, non lo è.
Il Costo Reale di un Fine-Tune
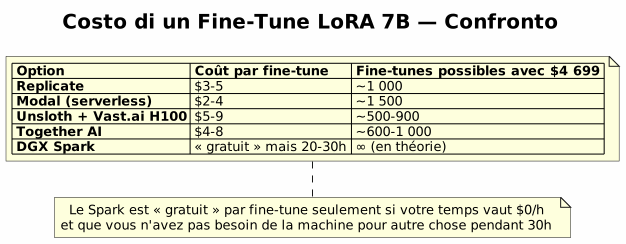
un fine-tune LoRA/QLoRA su Unsloth di un modello 7B:
-
~2-3h su un H100 =$5 a $9
-
Stessa cosa sul Spark =20-30h(10x più lento), blocca la macchina
Con i $4 699 di Spark, puoi finanziare:
-
~500 a ~900 fine-tunesnel cloud H100
-
Ou ~23 annidi Ollama Pro
-
Ou ~4 annidi Ollama Max
E per i modelli più grandi (70B+) :
-
Le Spark avec ses 128 Go peut charger un 70B en Q4 — mais le fine-tune sera extrêmement lent
-
Un H100 avec 80 Go peut fine-tuner un 70B en QLoRA 4-bit en quelques heures
-
Per un fine-tuning completo, serve comunque il multi-GPU — Spark è fuori gioco
Gli Attori Specializzati
Nel 2026, piattaforme come Unsloth, Modal, Replicate e Together AI propongono il fine-tuning serverless :
-
Nessuna gestione della GPU
-
Nessuna configurazione dell’ambiente
-
Pagamento al minuto
-
Ottimizzazioni integrate (flash attention, quantizzazione automatica)
L’unica vera ragione: la sovranità dei dati
Dopo aver eliminato l’inferenza, il fine‑tuning e il rapporto qualità/prezzo — cosa resta al Spark?
Assoluta riservatezza.
Non è questione di riservatezza «non voglio che i miei prompt vengano letti da un dipendente di OpenAI». Questo è un falso problema nel 2026: Ollama, Groq e la maggior parte dei provider rispettabili hanno politiche di zero log e zero retention.
La vera riservatezza, è:
-
Air-gap normativo: difesa, diplomazia, salute — i dati non possono fisicamente lasciare l’edificio
-
dati proprietari critici: codice sorgente di un prodotto non pubblicato, segreti industriali, algoritmi di trading
-
Resilienza di rete: l’IA deve continuare a funzionare anche se Internet cade
|
Ma siamo onesti: quale percentuale degli acquirenti di DGX Spark è realmente in questo caso? 1%? Il resto è semplicemente un «nice to have» trasformato in una spesa di $4 699. |
Il Vero Calcolo della Confidenzialità
Per uso individuale :
-
Ollama Pro($20/mese) + modelli open source cinesi = soluzione pragmatica
-
Se una richiesta trapelasse da Ollama, si perde tra i milioni di richieste giornaliere. È una goccia d’acqua nell’oceano.
-
Il rischio reale non è la fuga di un prompt — è l’addestramento non consensuale sui tuoi dati. E questo, i provider seri lo vietano per contratto.
__ La paura di « distillare il proprio prompt nel LLM » è un livello di diffusione di informazioni personali così diluito che appartiene più all’ansia che a una minaccia reale. Su scala industriale, è diverso. Ma su scala individuale, è solo rumore. (no output)
Sintesi : La Matrice di Decisione
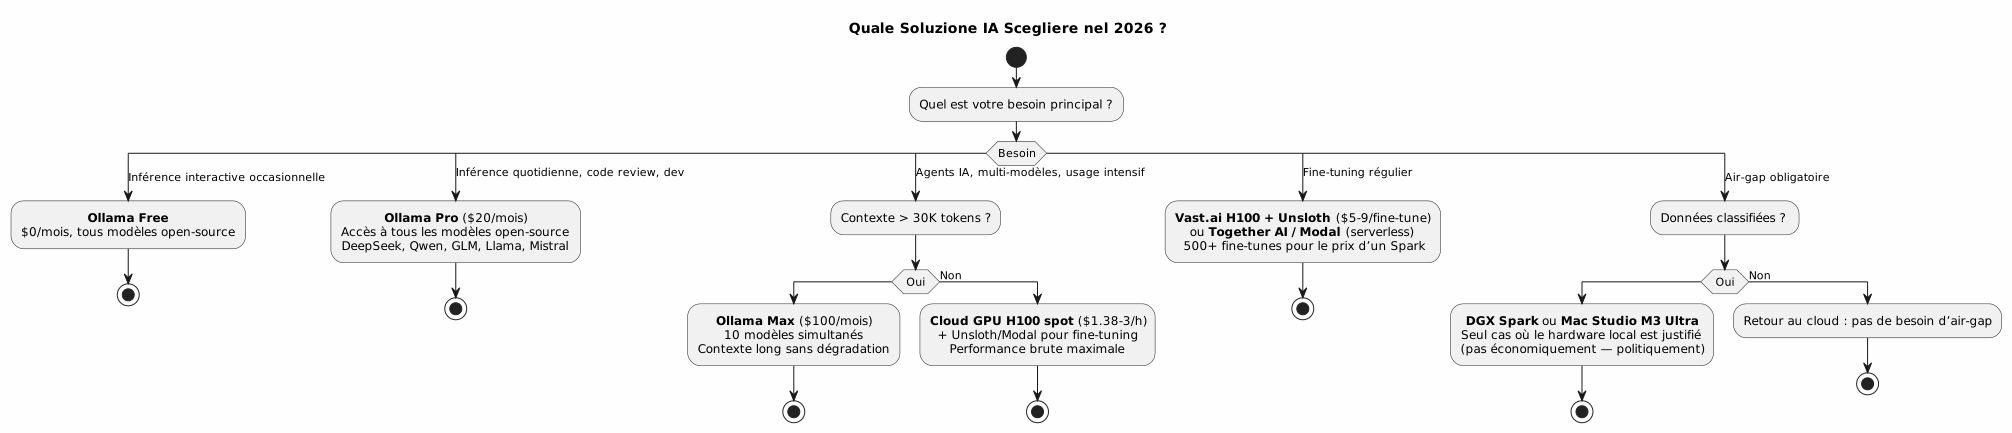
Criterio |
Ollama Free |
Ollama Pro |
GPU Cloud H100 |
DGX Spark |
Inferenza |
✅ limitata |
�✅ Comodo |
�✅ eccessivo |
�⚠️ Lento |
affinamento |
�❌ |
❌ |
✅ Imbattibile |
Possibile ma lento |
Costo annuo |
$0 |
$200 |
Variabile (~$416-2 080*) |
$4 699 anticipato |
riservatezza |
�⚠️ Cloud US |
�⚠️ Nuvola US |
�⚠️ Cloud US (variabile) |
✅ Totale |
Manutenzione |
Nessuna |
nessuna |
Impostazione unica |
Elettricità, aggiornamenti |
Obsolescenza |
nessuna |
nessuna |
Nessuna |
3-5 anni |
ecosistema software |
Tutti i modelli open |
Tutti modelli aperti |
Tutti i modelli open |
CUDA (più lento) |
Verdetto |
Occasionale |
Raccomandato |
Pro/Ricerca |
solo Air-gap |
*Variabile secondo il volume di lavoro ; con velocità H100 ~10x > Spark, il costo effettivo per un workload dato è basso._
Il Caso Particolare: L’Abbonamento Pro di Fronte ai Modelli Cinesi
Un punto merita di essere sottolineato: la combinazioneOllama Pro a $20/mese + modelli cinesi open-sourceè probabilmente il miglior rapporto qualità/prezzo della storia dell’IA di massa.
Perché i Modelli Cinesi Cambiano Tutto
-
DeepSeek-V4-Pro: 1.6T parametri, CSA+HCA, 1M contesto, competitivo con Claude 4 e GPT-5 per il codice
-
Qwen-3: 235B, 256K contesto, eccellente in francese e nel ragionamento
-
GLM-5.1: 744B, MLA+DSA, 200K contesto, su misura per l’agentico
Tutti disponibili su Ollama. Tutti open-source (licenze permissive). Tutti utilizzabili senza restrizioni tramite un abbonamento a $20/mese.
|
Con Ollama Pro, hai accesso a ~5 modelli « frontier » open-source al prezzo di un solo modello chiuso (Claude Pro). Il valore è così asimmetrico che diventa quasi assurdo. |
Che Cosa Significa per l’Hardware
Se il miglior rapporto qualità/prezzo è un abbonamento cloud a $20/mese, l’hardware locale diventa una scelta di confort o di principe — non una scelta economica.
Un DGX Spark a $4 699, è l’equivalente di :
-
235 mois d’Ollama Pro
-
23 giochi AAA giorno di uscita
-
4 MacBook Air M4
-
Un anno di affitto di un T2 a Lione
Per il calcolo. Lento.
E Huawei?
Poiché la domanda mi è stata posta durante le mie ricerche: no, Huawei non commercializza un equivalente al DGX Spark.
Ciò che esiste:
-
Ascend 910C : 128 Go HBM, 800 TFLOPS FP16 — mais c’est une puce serveur, pas un desktop
-
Atlas 300I Duo : 96 Go LPDDR4X, carte PCIe à ~$1 400 — nécessite un hôte
-
Atlas 350 : 112 Go HBM, 1.56 PFLOPS FP4 — accélérateur datacenter, pas un boîtier compact
Huawei reste focalisé sur le marché des serveurs et des centres de données. Pour un boîtier compact « prêt à brancher » avec 120+ Go de VRAM, le DGX Spark (128 Go unifié) et le Mac Studio M3 Ultra (192 Go unifié) sont les seules options en 2026. Et pour l’instant, aucun constructeur chinois n’a annoncé de produit équivalent dans ce format.
Conclusione: Il lusso della vicinanza
Il DGX Spark non è un cattivo prodotto. È un cattivo investimento per il 99% degli acquirenti potenziali.
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 9) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Il panorama dell'IA nel 2026 — Chi domina ?
left to right direction

package "Uso personale / PMI" #C8E6C9 {
  rectangle "🏆 Ollama Pro
^^^^^
 Syntax Error? (Assumed diagram type: class)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultTextAlignment center

title Il panorama dell'IA nel 2026 — Chi domina ?
left to right direction

package "Uso personale / PMI" #C8E6C9 {
  rectangle "🏆 Ollama Pro
$20/mese" as pro
  rectangle "Ollama Free
$0/mese" as free
  rectangle "Spot GPU cloud
$1-3/h" as spot
}

package "Usage Intensif / Pro" #FFF9C4 {
  rectangle "🏆 Ollama Max
$100/mese" as max
  rectangle "🏆 Cloud GPU dedicato\n$2-4/h" as dedicated
  rectangle "Modal / Together AI\nServerless" as serverless
}

package "Air-gap obbligatorio" #FFCDD2 {
  rectangle "DGX Spark
$4 699" as spark
  rectangle "Mac Studio M3U
~$5 000" as mac
}

note bottom of spark
  1% des cas d'usage — défense,
  santé réglementée, secrets
  industriels critiques
end note

@enduml
_ Acquistare un DGX Spark nel 2026 è come acquistare un server mail nel 2010: tecnicamente possibile, filosoficamente soddisfacente, economicamente assurdo per un individuo. _
Il calcolo è semplice, e non mente:
-
$0per chattare con DeepSeek su Ollama Free
-
$200/annoper lavorare seriamente con Ollama Pro
-
$5-9per un fine-tune occasionale su cloud GPU
-
$4 699per… l’esperienza di avere un case NVIDIA sulla sua scrivania ?
Il mercato ha deciso. Gli abbonamenti cloud e i modelli open-source cinesi hanno vinto la battaglia del prezzo. L’hardware locale sopravvive nelle nicchie regolamentari, non negli uffici degli sviluppatori.
(No output) Il DGX Spark non è uno strumento redditizio. È una statement. « Voglio la mia IA a casa mia, non nel cloud di qualcun altro. » È rispettabile. Ma nel 2026, quando Ollama ti offre DeepSeek-V4-Pro nel cloud per $20/mese, è soprattutto una statement che costa molto. (No output)
Questo articolo deriva da una conversazione con il mio agente IA sulla pertinenza economica del DGX Spark, incrociata con una vigilanza di mercato sui prezzi dei GPU cloud (Vast.ai, RunPod), le tariffe Ollama/Claude, e l’ecosistema dei modelli cinesi open-source. I prezzi citati sono quelli di maggio 2026 — probabilmente saranno ulteriormente diminuiti quando leggerai queste righe.
Articoli correlati
14 May 2026