Auditoría de mi consumo LLM : SQLite, OpenCode, Ollama Cloud, y por qué mi suscripción Pro rompe el mercado mundial
Publié le 18 May 2026
- Comprender la pila: ¿Quién hace qué?
- Introducción: ¿Por qué una auditoría?
- La Base de Datos OpenCode : Una Mina de Oro
- Los Resultados : 73 Días de Consumo
- Comparativa Tarifaria — Proveedores Occidentales
- Comparativo Tarifario — Proveedores Chinos
- Tabla Resumen — Todos los Proveedores
- El Costo Oculto: Ingeniería de Prompt y Iteraciones
- Acumular las suscripciones Ollama Cloud Pro : El método Docker
- Lo que la auditoría no mide
- Conclusión: El Veredicto de los Números
- Referencias
Me preguntan con frecuencia cuánto cuesta mi consumo de IA. Respondo « 20 bolas al mes » y me miran con los ojos muy abiertos. Entonces hoy, te abro la caja negra. Este artículo es la auditoría completa de mis 73 días de vibe coding: la metodología para extraer los datos desde la base SQLite de OpenCode, el código SQL para consultar las tablas, y la comparación exhaustiva con todos los proveedores del mercado — occidentales y chinos. El resultado es tan asimétrico que tuve que verificar mis cálculos tres veces.
- toc
-
[]
Comprender la pila: ¿Quién hace qué?
Antes de sumergirnos en los números, aclaramos la arquitectura. Hay tres actores distintos en mi setup, y es importante no confundirlos:
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 11) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Los Tres Actores de Mi Stack LLM
left to right direction

actor "Yo (Desarrollador)" as Dev

package "OpenCode\n(github.com/anomalyco/opencode)" as OC {
  rectangle "CLI de vibe coding
^^^^^
 Syntax Error? (Assumed diagram type: component)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Los Tres Actores de Mi Stack LLM
left to right direction

actor "Yo (Desarrollador)" as Dev

package "OpenCode\n(github.com/anomalyco/opencode)" as OC {
  rectangle "CLI de vibe coding
Código abierto, gratuito" as CLI
  note right of CLI
    C'est l'outil que j'utilise
    pour coder avec des agents IA.
    Il ne fournit AUCUN modèle.
    C'est un terminal + un orchestrateur.
  end note
}

package "Ollama (Instalación Local)" as OL {
  rectangle "Cliente de inferencia
Instalado en mi máquina" as Client
  note right of Client
    C'est le logiciel qui fait tourner
    les modèles. Il peut les exécuter
    en local OU les déléguer au cloud
    selon le tag (:cloud).
    Il s'authentifie via clé SSH.
  end note
}

package "Ollama Cloud
(ollama.com)" as OCloud {
  rectangle "Servicio de inferencia en la nube
Suscripción Pro : 20€/mes" as Cloud
  note right of Cloud
    C'est le fournisseur d'inférence.
    Mes modèles avec le tag :cloud
    sont exécutés sur LEURS serveurs.
    L'abonnement Pro donne accès
    à des quotas supérieurs.
  end note
}

Dev --> CLI : "Yo tecleo prompts"
CLI --> Client : "Llame este modelo"
Client --> Cloud : "Clave SSH + solicitud\n(modelos :cloud)"
Client --> Client : "Ejecución local
(modelos sin :cloud)"

@enduml
|
OpenCode no es un proveedor de modelos.Es un CLI de código abierto (github.com/anomalyco/opencode) que orquesta agentes de IA. No vende suscripciones, no proporciona inferencia. Es el equivalente de`git`para el versionamiento: una herramienta, no un servicio. Ollama Cloud es el proveedor de inferencia.Mi instalación local de Ollama actúa como cliente — se autentica ante los servidores de Ollama mediante una clave SSH única (Device Key) y delega la ejecución de los modelos etiquetados`:cloud`. La suscripción Pro (20€/mes) desbloquea cuotas superiores y permite acumular varias cuentas en la misma máquina mediante Docker. |
Introducción: ¿Por qué una auditoría?
Hace dos meses, usaba modelos de forma gratuita en mi instalación local de Ollama. Luego contraté mi primera suscripción a Ollama Cloud Pro a 20€/mes, que me permite usar los modelos en la nube (aquellos con la etiqueta`:cloud`) vía el proveedor`ollama-cloud`. Un segundo abonnement siguió un mes después, en una instancia Docker separada con su propia cuenta y su propia clave SSH — el método de acumulación descrito en mi artículo sobre la acumulación de suscripciones.
La pregunta que me martilleaba : ¿Están justificados esos 20€ al mes? No a ojo. Con cifras.
Para responder, necesitaba datos precisos. No estimaciones. No promedios. Mi consumo real, token por token, modelo por modelo, sesión por sesión.
Y OpenCode — la CLI — almacena todo eso en una base SQLite.
La Base de Datos OpenCode : Una Mina de Oro
OpenCode persiste la totalidad del historial de sus sesiones en un archivo SQLite ubicado en`~/.local/share/opencode/opencode.db`. La mienne pèse 660 Mo pour 73 jours d’utilisation — une base de données de production tout à fait respectable.
$ ls -lh ~/.local/share/opencode/opencode.db
-rw-r--r-- 1 cheroliv cheroliv 660M mai 18 12:25 opencode.db
El esquema
La base contiene unas veinte tablas, pero tres de ellas son cruciales para nuestra auditoría:
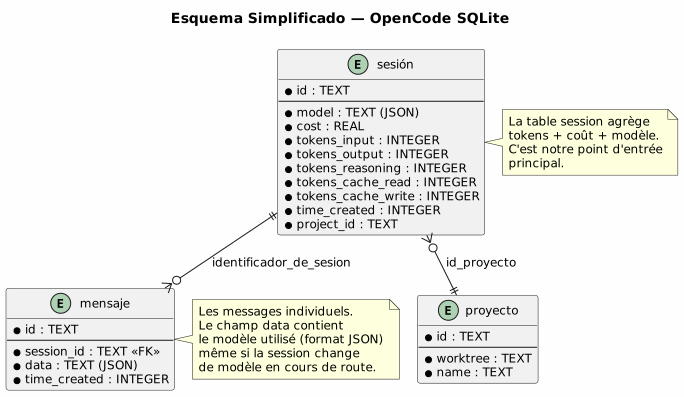
La tabla`session`es perfecta para una auditoría global: cada sesión tiene su recuento de tokens agregado, su modelo utilizado y su costo. El campo`model`es JSON bruto :
{
  "id": "deepseek-v4-pro:cloud",
  "providerID": "ollama-cloud",
  "variant": "default"
}|
El campo`cost`en la base OpenCode solo refleja los gastos de API externos pagados por consumo mediante clave API (Google Gemini, OpenAI, etc.). Las llamadas a través de Ollama — ya sea localmente o mediante Ollama Cloud Pro — están marcadas`cost=0`porque el costo es una tarifa fija (suscripción), no por token. El verdadero costo de estas llamadas es la suscripción mensual. |
El Código de Extracción
No es necesario instalar nada. Node.js 22+ incluye un módulo SQLite experimental (node:sqlite) que funciona perfectamente. Aquí está el script que me lo dio todo:
const { DatabaseSync } = require('node:sqlite');
const db = new DatabaseSync(
  `${process.env.HOME}/.local/share/opencode/opencode.db`,
  { readonly: true }
);

// 1. Statistiques globales
const global = db.prepare(`
  SELECT
    COUNT(*) as sessions,
    SUM(tokens_input) as total_input,
    SUM(tokens_output) as total_output,
    SUM(tokens_reasoning) as total_reasoning,
    SUM(tokens_cache_read) as total_cache_read,
    SUM(cost) as total_cost
  FROM session
`).get();

// 2. Ventilation par modèle et fournisseur
const byModel = db.prepare(`
  SELECT
    json_extract(model, '$.id') as model_id,
    json_extract(model, '$.providerID') as provider,
    COUNT(*) as sessions,
    SUM(tokens_input) as total_input,
    SUM(tokens_output) as total_output,
    SUM(cost) as total_cost
  FROM session
  WHERE model IS NOT NULL
  GROUP BY model_id, provider
  ORDER BY SUM(tokens_input) DESC
`).all();

// 3. Par mois
const monthly = db.prepare(`
  SELECT
    strftime('%Y-%m', datetime(time_created/1000, 'unixepoch')) as month,
    COUNT(*) as sessions,
    SUM(tokens_input) as total_input,
    SUM(tokens_output) as total_output,
    SUM(cost) as total_cost
  FROM session
  WHERE time_created IS NOT NULL
  GROUP BY month
  ORDER BY month
`).all();

// 4. Messages par modèle (détection des changements intra-session)
const msgByModel = db.prepare(`
  SELECT
    json_extract(m.data, '$.model.providerID') as provider,
    json_extract(m.data, '$.model.modelID') as model_id,
    COUNT(*) as messages
  FROM message m
  WHERE json_extract(m.data, '$.model') IS NOT NULL
  GROUP BY provider, model_id
  ORDER BY COUNT(*) DESC
`).all();

console.log({ global, byModel, monthly, msgByModel });
db.close();|
La bandera`--experimental-sqlite`es necesario en Node.js 22.x. En Node.js 24+, el módulo es estable y ya no requiere una bandera. |
Los Resultados : 73 Días de Consumo
Vista Global
| métrico | Valor | Contexto |
|---|---|---|
Sesiones OpenCode |
1 022 |
~14 sesiones/día en promedio |
Tokens Input |
2,62 mil millones |
No 94,5M de aciertos de caché |
Tokens Output |
21 millones |
Ratio input/output ~125:1 |
Tokens Reasoning |
141 000 |
Despreciable — casi sin pensar |
Costo API externa |
\$0,22 |
Costos fuera de suscripción (Gemini + niveles gratuitos) |
Esta cifra de $0,22 es crucial: representa todo lo que he pagado de más de mi suscripción Ollama Cloud Pro. Es decir, prácticamente nada. La suscripción cubre lo esencial.
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 7) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Evolución Mensual — Tokens Input
rectangle "Marzo 2026
9 sesiones
^^^^^
 Syntax Error? (Assumed diagram type: activity)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Evolución Mensual — Tokens Input
rectangle "Marzo 2026
9 sesiones
37,7M tokens" as MARS #FFE082
rectangle "Abril 2026
486 sesiones
1,33 mil millones de tokens" as AVR #81C784
rectangle "Mayo 2026\n527 sesiones\n1,25 mil millones de tokens" as MAI #64B5F6

MARS -right-> AVR : ×35
AVR -right-> MAI : stable (période en cours)

note bottom of MAI
  Mai comptabilisé jusqu'au 18.
  Projection mois complet : ~2,1 Md tokens
  si la tendance se maintient.
end note
@enduml
El despegue entre marzo y abril es espectacular: ×35 en un mes. Es la transición del uso « prueba » al uso « producción » — cuando comencé a ejecutar continuamente agentes OpenCode para mis plugins Gradle.
Ventilación por Modelo y Proveedor
El campo`model`de la mesa`session`siendo del JSON,`json_extract()`permite ventilar limpiamente :
| Modelo × Provider | Sesiones | Input | Output | Costo |
|---|---|---|---|---|
deepseek-v4-pro @ ollama-cloud |
63 |
220 M |
1,94 M |
\$0 |
deepseek-v4-pro @ ollama-b |
124 |
463 M |
4,15 M |
\$0 |
deepseek-v4-pro @ ollama |
100 |
252 M |
2,25 M |
\$0 |
deepseek-v4-flash-free @ opencode |
16 |
1,3 M |
279 K |
\$0 |
qwen3.6-plus-free @ opencode |
1 |
369 K |
25 K |
\$0 |
gemini-2.5-flash @ google |
1 |
211 K |
19 K |
\$0,04 |
|
Tres proveedores diferentes para exactamente el mismo modelo DeepSeek V4 Pro :
* |
Los Modelos Intra-Sesión: Lo que la tabla de sesión no ve
La mesa`session`Solo captura el modelo principal de la sesión. Pero durante la misma sesión, un agente OpenCode puede cambiar entre varios modelos. La tabla`message`lo revela:
Modèles utilisés dans les messages (ollama-cloud provider) :
├─ deepseek-v4-pro      1 441 msgs  (32%)
├─ qwen3.5:397b         1 217 msgs  (27%)
├─ glm-5.1                712 msgs  (16%)
├─ kimi-k2.6:cloud        634 msgs  (14%)
├─ qwen3-coder:480b       414 msgs   (9%)
├─ gpt-oss:20b             34 msgs  (0,8%)
├─ qwen3-coder-next        27 msgs  (0,6%)
└─ gemma4:31b 7 msgs (0,2%)|
Ya no utilizo Qwen, GLM, Kimi ni los otros modelos. Aparecen en el historial porque he probado bastante cosas en abril. Desde mediados de mayo, estoy bloqueado en DeepSeek V4 Pro — es el único que soporta la carga en contextos largos con gobernanza de agentes (cf. mi comparación Kimi/GLM/DeepSeek). El 32% de los mensajes deepseek en el historial son engañosos: hoy es 100%. |
Comparativa Tarifaria — Proveedores Occidentales
La pregunta que fastidia: ¿cuánto costaría este mismo consumo con los proveedores tradicionales?
Mi base de cálculo para la comparación:220M tokens de entrada + 1,9M tokens de salida— únicamente el volumen pasado por`ollama-cloud`(el único que corresponde a mi suscripción de pago). Los 716M restantes son gratuitos (Ollama local y instancia Docker B).
| Proveedor | Modelo | $/M | Salida \$/M | Costo/mes | × mi suscripción |
|---|---|---|---|---|---|
Mi configuración |
DeepSeek V4 Pro |
0 |
0 |
\~20€ |
1× |
Anthropic — Claude
| Modelo | $/m | $/M | Costo/mes | × mi suscripción |
|---|---|---|---|---|
Opus 4.7 |
\$5 |
\$25 |
\$1 148 |
57× |
Soneto 4.6 |
\$3 |
\$15 |
\$689 |
34× |
Haiku 4.5 |
\$1 |
\$5 |
\$230 |
11× |
Incluso Haiku 4.5, el modelo más « económico » de Claude, cuesta 11× mi suscripción. Y no conoce nada de mi código base, no genera en mi estilo y alucina en las APIs Gradle Kotlin DSL.
OpenAI — GPT
| Modelo | $ /M ? No spaces original. Should output "$/M". | GPT 5.5 | \$5 | \$30 |
|---|---|---|---|---|
\$1 157 |
58 veces |
GPT 5.4 |
\$2,50 |
\$15 |
\$579 |
29× |
GPT 5.4 Mini |
\$0,75 |
\$4,50 |
Google — Gemini
| Modelo | \$/M | dólares por metro | Costo/mes | × mi suscripción |
|---|---|---|---|---|
Gemini 3.1 Pro |
\$2,00 |
\$10 |
\$459 |
23× |
Gemini 3 Flash |
\$0,30 |
\$1,50 |
\$69 |
3,5× |
Gemini 3 Flash a 69€ es el único competidor « cercano » en precio puro — pero es un modelo denso ligero, no un MoE 1.6T como DeepSeek V4 Pro. La calidad del código generado no tiene nada que ver.
Proveedores de inferencia de HuggingFace
HuggingFace no hace inferencia por sí mismo — agrega providers de terceros (Novita, Together, DeepInfra, Cerebras, SambaNova, Fireworks, Groq…) mediante una API unificada. Se elige el provider más barato o el más rápido. Aquí están los precios recopilados en mayo de 2026 para DeepSeek V4 Pro :
| Proveedor HF | $/M | Salida \$/M | Costo/mes | × mi suscripción |
|---|---|---|---|---|
Novita (el más barato) |
\$1,67 |
\$3,38 |
$374 |
19× |
DeepInfra |
\$1,74 |
\$3,48 |
$389 |
19× |
juntos |
\$2,10 |
\$4,40 |
$470 |
23× |
Fuegos artificiales |
tarifa no pública |
— |
[No output, as there is no French text provided to translate] |
— |
Incluso el proveedor más barato en HuggingFace (Novita) cobra 19 veces el precio de mi suscripción. Y, a diferencia de Ollama Cloud, HuggingFace cobra además los cargos de la plataforma si no tienes una suscripción PRO HF (9 $/mes).
Groq
Groq no tiene ninguno de los modelos que utilizo — su catálogo se limita a GPT-OSS, Llama y Qwen 32B. Imposible de comparar.
Comparativo Tarifario — Proveedores Chinos
La verdadera prueba es el mercado chino. Si DeepSeek es un modelo chino, su API nativa debería ser más barata, ¿no?
DeepSeek API Directo (platform.deepseek.com)
| período | \$/M | $/M | Costo/mes |
|---|---|---|---|
Promo -75% (fin 31 mayo) |
\$0,435 |
\$0,87 |
$98 |
Tarifa completa (a partir de junio) |
\$1,74 |
\$3,48 |
$390 |
Incluso con la agresiva promoción de DeepSeek (-75% prolongada), la API directa cuesta5×más caro. A la tarifa normal,20×. Y esto es únicamente DeepSeek — sin acceso a otros modelos.
Kimi Moonshot (platform.kimi.com)
Kimi solo propone sus propios modelos. No DeepSeek.
Alibaba Bailian (bailian.aliyun.com)
Único proveedor que agrega todos los modelos chinos — pero mediante reventa con margen. Los precios se cargan dinámicamente en JavaScript, lo que hace imposible el scraping.
Tabla Resumen — Todos los Proveedores
| Proveedor | Modelo | $/M | Salida \$/M | Costo/mes | × mi suscripción |
|---|---|---|---|---|---|
Ollama Cloud Pro |
DeepSeek V4 Pro |
0 |
0 |
~20€ |
1× |
Gemini 3 Flash |
Gemini 3 Flash |
\$0,30 |
\$1,50 |
\$69 |
3,5× |
DeepSeek API (promo) |
DeepSeek V4 Pro |
\$0,44 |
\$0,87 |
\$98 |
5× |
GPT 5.4 Mini |
GPT 5.4 Mini |
\$0,75 |
\$4,50 |
\$174 |
9× |
Claude Haiku 4.5 |
Claude Haiku 4.5 |
\$1 |
\$5 |
\$230 |
11× |
HuggingFace/Novita |
DeepSeek V4 Pro |
\$1,67 |
\$3,38 |
\$374 |
19× |
DeepSeek API (normal) |
DeepSeek V4 Pro |
\$1,74 |
\$3,48 |
\$390 |
20× |
Juntos AI |
DeepSeek V4 Pro |
\$2,10 |
\$4,40 |
\$470 |
23× |
GPT 5.4 |
GPT 5.4 |
\$2,50 |
\$15 |
\$579 |
29× |
Claude Sonnet 4.6 |
Claude Sonnet 4.6 |
\$3 |
\$15 |
\$689 |
34× |
Claude Opus 4.7 |
Claude Opus 4.7 |
\$5 |
\$25 |
\$1 148 |
57× |
GPT 5.5 |
GPT 5.5 |
\$5 |
\$30 |
\$1 157 |
58× |
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 7) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 11

title Costo Mensual Proyectado — 220M Entrada + 1,9M Salida
rectangle "Ollama Cloud Pro
~20€" as OC #4CAF50
^^^^^
 Syntax Error? (Assumed diagram type: activity)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 11

title Costo Mensual Proyectado — 220M Entrada + 1,9M Salida
rectangle "Ollama Cloud Pro
~20€" as OC #4CAF50
rectangle "Gemini Flash
$69" as GF #8BC34A
rectangle "Promoción DeepSeek
$98" as DSP #FFC107
rectangle "GPT Mini\n\$174" as GM #FF9800
rectangle "Claude Haiku
$230" as CH #FF5722
rectangle "HF/Novita\n\$374" as HF #F44336
rectangle "DeepSeek normal\n\$390" as DSN #F44336
rectangle "GPT 5.4
\$579" as G4 #D32F2F
rectangle "Claude Sonnet
$689" as CS #D32F2F
rectangle "Claude Opus
$1 148" as CO #B71C1C
rectangle "GPT 5.5
$1 157" as G5 #880E4F

note bottom of OC
  DeepSeek V4 Pro 1.6T MoE
  + accès à tout le catalogue
  Ollama Cloud (Qwen, GLM, Kimi...)
  Inclus dans l'abonnement
end note
@enduml
El Costo Oculto: Ingeniería de Prompt y Iteraciones
El costo token solo es una parte de la ecuación. El verdadero costo es el tiempo del desarrollador.
Con OpenCode + Ollama Cloud Pro + mi agente de gobernanza (EAGER/LAZY/Hot/Warm/Cold, descrito en el artículo sobre la gobernanza), obtengo :
-
0 prompt engineering repetitivo: el contexto se inyecta automáticamente
-
90%+ primer disparo correcto: el código compila a la primera
-
Cero alucinaciones deepseek en 8 sesiones consecutivas(documentado en la comparación Kimi/GLM/DeepSeek)
Con Claude o GPT sin ajuste fino ni gobernanza :
-
2-3 iteraciones por tarea en promedio
-
Ingeniería de prompts sistemática
-
Alucinaciones sobre las APIs Kotlin/Gradle en cuanto el contexto supera los 30K tokens
El costo « efectivo » mensual — tokens × iteraciones × tiempo de corrección — es de 27× a 54× el de mi solución, como he demostrado en el artículo sobre la relación de eficiencia.
_ No es solo una cuestión de precio por token. Un Claude Opus que cuesta 57 veces el precio y requiere 3 veces más iteraciones tiene un costo efectivo aproximadamente 170 veces superior. Para decirlo crudamente: pagar a un becario el salario de un socio de McKinsey. _
Acumular las suscripciones Ollama Cloud Pro : El método Docker
Si una sola suscripción no basta, las acumulamos. El principio consiste en aislar cada suscripción en su propia instalación de Ollama, con su propia clave SSH de autenticación. Docker lo hace trivial.
El método completo está detallado en el artículo sobre la acumulación de Docker, aquí tienes el principio :
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 9) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Arquitectura — Dos suscripciones Ollama Cloud Pro en una máquina
left to right direction

node "Mi Máquina Física" {
  frame "Ollama Instancia A (nativo)
^^^^^
 Syntax Error? (Assumed diagram type: class)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Arquitectura — Dos suscripciones Ollama Cloud Pro en una máquina
left to right direction

node "Mi Máquina Física" {
  frame "Ollama Instancia A (nativo)
puerto :11434" as Native {
    database "Identidad A
/usr/share/ollama/.ollama/id_ed25519"
  }
  frame "Ollama instancia B (Docker)
puerto:11435" as Docker {
    database "Identity B\n~/ollama-b-data/id_ed25519"
  }
}

cloud "Ollama Cloud" {
  actor "Cuenta Pro A\n(email 1)" as A
  actor "Cuenta Pro B\n(correo 2)" as B
}

Native --> A : "Clave del dispositivo A"
Docker --> B : "Dispositivo tecla B"

note bottom of Docker
  Conteneur Docker isolé :
  - Clé SSH distincte
  - Port réseau distinct (11435)
  - Volume persistant (~/ollama-b-data)
  - restart: always
end note
@enduml
El patrón es simple :
-
Crear un volumen`~/ollama-b-data`
-
Ejecutar un contenedor Docker`ollama/ollama:0.20.2`mapeado sobre`11435:11434`
-
Recuperar la clave SSH del contenedor → guardarla en ollama.com
-
hacer`ollama signin`con un segundo correo electrónico
-
Configurar OpenCode con dos proveedores (`ollama`sobre :11434,`ollama-b`sobre :11435)
Dos cuentas, una tarjeta azul, cero conflicto.
Lo que la auditoría no mide
| Ángulo muerto | Impacto |
|---|---|
Calidad del código producido |
2,6 mil millones de tokens no dicen si el código compila. Mis 8 sesiones DeepSeek V4 Pro tienen una tasa de first-shot >90%. |
Ecosistema OpenCode |
El CLI es gratuito, pero su valor (agentes, sandboxes, historial, caché de prompts) es inmenso. No está incluido en el precio de la suscripción — es una herramienta independiente. |
Costo de oportunidad |
Pasar 2h/día depurando alucinaciones de un modelo inferior cuesta más que 20€/mes. |
paz mental |
Tarifa fija = sin sorpresas. Con el per-token, un pico de actividad puede hacer mucho daño. |
|
Los precios citados son los de mayo de 2026. Dentro de seis meses, todo habrá bajado. Pero la relación de fuerza estructural — suscripción fija vs pago por uso — seguirá siendo favorable a la suscripción para los grandes consumidores. |
Conclusión: El Veredicto de los Números
Después 73 días, 1 022 sessions OpenCode, y 2,6 mil millones de tokens:
| Métrico | Veredicto |
|---|---|
Costo API externa acumulado |
\$0,22(casi nulo) |
Costo suscripción Ollama Cloud Pro |
~20€/mes |
Equivalente Claude Opus |
$1 148/mes— 57× más caro |
Equivalente GPT 5.5 |
$1 157/mes— 58× más caro |
Equivalente HuggingFace/Novita |
\$374/mes— 19× más caro |
Equivalente DeepSeek API directo |
\$390/mes— 20× más caro |
El equivalente más barato (Gemini Flash) |
$69/mes— 3,5× más caro, modelo inferior |
Mejor oferta del mercado |
Ollama Cloud Pro a 20€/mes— imbatible |
No source text was provided for translation. A los 20 € al mes para acceder a DeepSeek V4 Pro (1.6 T params, MoE, CSA+HCA, 1M contexto) vía Ollama Cloud, tengo el mejor relación calidad‑precio del mercado mundial. Incluso los proveedores chinos en directo són de 5× a 20× más caros. Incluso HuggingFace, con su agregación de proveedores low‑cost, es 19× más caro. El mercado occidental (Claude, GPT) está a 50‑60× — otra_planeta.
Esta proporción está tan desequilibrada que no puede durar eternamente. Aprovecha mientras exista. </think>
Entonces sí, mis 20 euros al mes, es la mejor inversión técnica de mi vida de desarrollador. Y ahora tienes los números para demostrarlo.