Auditoria do meu Consumo LLM : SQLite, OpenCode, Ollama Cloud, e Por Que Minha Assinatura Pro Estoura o Mercado Mondial
Publié le 18 May 2026
- Compreender a Stack: Quem Faz o Que?
- Introdução : Por que realizar uma auditoria ?
- A Base de Dados OpenCode : Uma Mina de Ouro
- Os Resultados: 73 Dias de Consumo
- Comparativo Tarifário — Fornecedores Ocidentais
- Comparativo Tarifário — Fornecedores Chineses
- Tabela Resumo — Todos Providers
- O Custo Oculto : Engenharia de Prompts e Iterações
- Acumular as Assinaturas Ollama Cloud Pro: O Método Docker
- O Que a Auditoria Não Mede
- Conclusão: O Veredito dos Números
- Referências
Muitas vezes me perguntam quanto custa meu consumo de IA. Eu respondo « 20 euros por mês » e eles me olham com os olhos arregalados. Então hoje, eu abro a caixa preta para vocês. Este artigo é a auditoria completa dos meus 73 dias de vibe coding : a metodologia para extrair os dados da base SQLite d’OpenCode, o código SQL para consultar as tabelas, e a comparação exaustiva com todos os fornecedores do mercado — ocidentais como chineses. O resultado é tão assimétrico que tive que verificar meus cálculos três vezes.
- toc
-
</think>
Compreender a Stack: Quem Faz o Que?
Antes de mergulhar nos números, vamos esclarecer a arquitetura. Há três atores distintos no meu setup, e é importante não confundir os três :
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 11) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Os Três Atores da Minha Stack LLM
left to right direction

actor "Eu (Desenvolvedor)" as Dev

package "OpenCode\n(github.com/anomalyco/opencode)" as OC {
  rectangle "CLI de vibe coding
^^^^^
 Syntax Error? (Assumed diagram type: component)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Os Três Atores da Minha Stack LLM
left to right direction

actor "Eu (Desenvolvedor)" as Dev

package "OpenCode\n(github.com/anomalyco/opencode)" as OC {
  rectangle "CLI de vibe coding
Código aberto, gratuito" as CLI
  note right of CLI
    C'est l'outil que j'utilise
    pour coder avec des agents IA.
    Il ne fournit AUCUN modèle.
    C'est un terminal + un orchestrateur.
  end note
}

package "Ollama (Instalação Local)" as OL {
  rectangle "Cliente de inferência\nInstalado na minha máquina" as Client
  note right of Client
    C'est le logiciel qui fait tourner
    les modèles. Il peut les exécuter
    en local OU les déléguer au cloud
    selon le tag (:cloud).
    Il s'authentifie via clé SSH.
  end note
}

package "Ollama Cloud
(ollama.com)" as OCloud {
  rectangle "Serviço de inferência em nuvem
Assinatura Pro : 20€/mês" as Cloud
  note right of Cloud
    C'est le fournisseur d'inférence.
    Mes modèles avec le tag :cloud
    sont exécutés sur LEURS serveurs.
    L'abonnement Pro donne accès
    à des quotas supérieurs.
  end note
}

Dev --> CLI : "Eu digito prompts"
CLI --> Client : "Chame este modelo"
Client --> Cloud : "Chave SSH + requisição\n(modelos :cloud)"
Client --> Client : "Execução local
(modelos sem :cloud)"

@enduml
|
OpenCode NÃO é um fornecedor de modelos.É um CLI de código aberto (github.com/anomalyco/opencode) que orquestra agentes de IA. Ele não vende assinatura, ele não fornece inferência. É o equivalente de`git`para versionamento: uma ferramenta, não um serviço. Ollama Cloud é o fornecedor da inferência.Minha instalação local do Ollama atua como client — ela se autentica nos servidores do Ollama por meio de uma chave SSH única (Device Key) e delega a execução dos modelos marcados a eles`:cloud`. A assinatura Pro (20€/mês) desbloqueia quotas superiores e permite acumular várias contas na mesma máquina via Docker. |
Introdução : Por que realizar uma auditoria ?
Há dois meses, estava usando modelos gratuitamente na minha instalação local do Ollama. Então assinei um primeiro plano Ollama Cloud Pro de 20€/mês, que me permite usar os modelos em nuvem (aqueles com a tag`:cloud`) via o provider`ollama-cloud`. Uma segunda assinatura ocorreu um mês depois, em uma instância Docker separada com sua própria conta e chave SSH — o método de acumulação descrito em meu artigo sobre a acumulação de assinaturas
A pergunta que me atormentava : será que esses 20€ por mês são justificados ? Não de bate-pronto. Com números.
Para responder, eu precisava de dados precisos. Não eram estimativas. Não eram médias. Meu consumo real, token por token, modelo por modelo, sessão por sessão.
E OpenCode — a CLI — armazena tudo isso em um banco de dados SQLite.
A Base de Dados OpenCode : Uma Mina de Ouro
OpenCode persiste a integralidade do histórico de suas sessões em um arquivo SQLite localizado em`~/.local/share/opencode/opencode.db`. La mienne pèse 660 Mo pour 73 jours d’utilisation — une base de données de production tout à fait respectable.
$ ls -lh ~/.local/share/opencode/opencode.db
-rw-r--r-- 1 cheroliv cheroliv 660M mai 18 12:25 opencode.db
O esquema
A base contém cerca de vinte tabelas, mas três delas são cruciais para nossa auditoria:
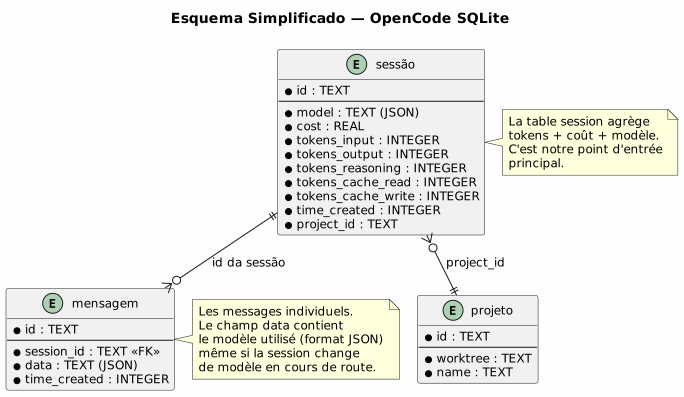
A mesa`session`é perfeita para uma auditoria global: cada sessão tem sua contagem agregada de tokens, o modelo utilizado e seu custo. O campo`model`é JSON bruto:
{
  "id": "deepseek-v4-pro:cloud",
  "providerID": "ollama-cloud",
  "variant": "default"
}|
o campo`cost`na base OpenCode reflete apenas as taxas de API externas pagas por consumo via chave de API (Google Gemini, OpenAI, etc.). As chamadas via Ollama — seja localmente ou via Ollama Cloud Pro — são marcadas`cost=0`Porque o custo é fixo (assinatura), não por token. O verdadeiro custo dessas chamadas é a assinatura mensal. |
O Código de Extração
Não é preciso instalar nada. Node.js 22+ inclui um módulo SQLite experimental (node:sqlite) que funciona perfeitamente. Aqui está o script que me deu tudo:
const { DatabaseSync } = require('node:sqlite');
const db = new DatabaseSync(
  `${process.env.HOME}/.local/share/opencode/opencode.db`,
  { readonly: true }
);

// 1. Statistiques globales
const global = db.prepare(`
  SELECT
    COUNT(*) as sessions,
    SUM(tokens_input) as total_input,
    SUM(tokens_output) as total_output,
    SUM(tokens_reasoning) as total_reasoning,
    SUM(tokens_cache_read) as total_cache_read,
    SUM(cost) as total_cost
  FROM session
`).get();

// 2. Ventilation par modèle et fournisseur
const byModel = db.prepare(`
  SELECT
    json_extract(model, '$.id') as model_id,
    json_extract(model, '$.providerID') as provider,
    COUNT(*) as sessions,
    SUM(tokens_input) as total_input,
    SUM(tokens_output) as total_output,
    SUM(cost) as total_cost
  FROM session
  WHERE model IS NOT NULL
  GROUP BY model_id, provider
  ORDER BY SUM(tokens_input) DESC
`).all();

// 3. Par mois
const monthly = db.prepare(`
  SELECT
    strftime('%Y-%m', datetime(time_created/1000, 'unixepoch')) as month,
    COUNT(*) as sessions,
    SUM(tokens_input) as total_input,
    SUM(tokens_output) as total_output,
    SUM(cost) as total_cost
  FROM session
  WHERE time_created IS NOT NULL
  GROUP BY month
  ORDER BY month
`).all();

// 4. Messages par modèle (détection des changements intra-session)
const msgByModel = db.prepare(`
  SELECT
    json_extract(m.data, '$.model.providerID') as provider,
    json_extract(m.data, '$.model.modelID') as model_id,
    COUNT(*) as messages
  FROM message m
  WHERE json_extract(m.data, '$.model') IS NOT NULL
  GROUP BY provider, model_id
  ORDER BY COUNT(*) DESC
`).all();

console.log({ global, byModel, monthly, msgByModel });
db.close();|
O flag`--experimental-sqlite`É necessário no Node.js 22.x. No Node.js 24+, o módulo é estável e não requer mais nenhum sinalizador. |
Os Resultados: 73 Dias de Consumo
Visão Global
| Métrica | Valor | Contexto |
|---|---|---|
Sessões OpenCode |
1 022 |
~14 sessões por dia em média |
tokens de entrada |
2,62 bilhões |
Dont 94,5M em acertos de cache |
Tokens Output |
21 milhões |
Ratio input/output ~125:1 |
Tokens Reasoning |
141 000 |
Negligível — quase nenhum pensamento |
Custo da API externa |
\$0,22 |
Custos fora da assinatura (Gemini + free tiers) |
Este número de $0,22 é crucial: representa tudo o que eu paguei além da minha assinatura Ollama Cloud Pro. Ou seja, praticamente nada. A assinatura cobre o essencial.
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 7) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Evolução Mensal — Tokens de Entrada
rectangle "Março 2026
9 sessões
^^^^^
 Syntax Error? (Assumed diagram type: activity)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Evolução Mensal — Tokens de Entrada
rectangle "Março 2026
9 sessões
37,7M tokens" as MARS #FFE082
rectangle "Abril 2026
486 sessões
1,33 Md tokens" as AVR #81C784
rectangle "Maio 2026
527 sessões
1,25 bi tokens" as MAI #64B5F6

MARS -right-> AVR : ×35
AVR -right-> MAI : stable (période en cours)

note bottom of MAI
  Mai comptabilisé jusqu'au 18.
  Projection mois complet : ~2,1 Md tokens
  si la tendance se maintient.
end note
@enduml
O decolagem entre março e abril é espetacular: ×35 em um mês. É a transição do uso « teste » para o uso « produção » — quando comecei a fazer rodar agentes OpenCode continuamente para meus plugins Gradle.
Ventilação por Modelo e Fornecedor
O campo`model`da mesa`session`sendo JSON,`json_extract()`permite ventilar adequadamente :
| Modelo × Provider | Sessões | [No output, as no French text was provided for translation] | Output | Custo |
|---|---|---|---|---|
deepseek-v4-pro @ ollama-cloud |
63 |
220 M |
1,94 M |
\$0 |
deepseek-v4-pro @ ollama-b |
124 |
463 M |
4,15 M |
\$0 |
deepseek-v4-pro @ ollama |
100 |
252 M |
2,25 M |
\$0 |
deepseek-v4-flash-free @ opencode |
16 |
1,3 M |
279 K |
\$0 |
qwen3.6-plus-free @ opencode |
1 |
369 K |
25 K |
\$0 |
gemini-2.5-flash @ google |
1 |
211 K |
19 K |
\$0,04 |
|
Três provedores diferentes para exatamente o mesmo modelo DeepSeek V4 Pro :
* |
Os Modelos Intra-Sessão: O Que a Tabela de Sessão Não Vê
A mesa`session`Captura apenas o modelo principal da sessão. Mas durante a mesma sessão, um agente OpenCode pode alternar entre vários modelos. A tabela`message`o revela :
Modèles utilisés dans les messages (ollama-cloud provider) :
├─ deepseek-v4-pro      1 441 msgs  (32%)
├─ qwen3.5:397b         1 217 msgs  (27%)
├─ glm-5.1                712 msgs  (16%)
├─ kimi-k2.6:cloud        634 msgs  (14%)
├─ qwen3-coder:480b       414 msgs   (9%)
├─ gpt-oss:20b             34 msgs  (0,8%)
├─ qwen3-coder-next        27 msgs  (0,6%)
└─ gemma4:31b 7 msgs (0,2%)|
Não uso mais Qwen, GLM, Kimi nem os outros modelos. Eles aparecem no histórico porque testei muitas coisas em abril. Desde meados de maio, estou bloqueado no DeepSeek V4 Pro — é o único que sustenta a carga em contextos longos com governança de agente (cf. minha comparação Kimi/GLM/DeepSeek). Os 32% de mensagens deepseek no histórico são enganosos: hoje é 100%. |
Comparativo Tarifário — Fornecedores Ocidentais
A questão que fere : quanto custaria esse mesmo consumo junto aos fornecedores tradicionais?
Minha base de cálculo para o comparativo :220M tokens de entrada + 1,9M tokens de saída— apenas o volume passado por`ollama-cloud`(o único que corresponde ao meu plano pago). Os 716M restantes são gratuitos (Ollama local e instância Docker B).
| fornecedor | Modelo | \$/M | Output \$/M | Custo/mês | × minha assinatura |
|---|---|---|---|---|---|
Minha configuração |
DeepSeek V4 Pro |
0 |
0 |
\~20€ |
1× |
Anthropic — Claude
| Modelo | $/M | Saída \$/M | Custo/mês | × minha assinatura |
|---|---|---|---|---|
Opus 4.7 |
\$5 |
\$25 |
\$1 148 |
57× |
Soneto 4.6 |
\$3 |
\$15 |
\$689 |
34× |
Haiku 4.5 |
\$1 |
\$5 |
\$230 |
11× |
Mesmo o Haiku 4.5, o modelo mais « econômico » da Claude, custa 11× a minha assinatura. E ele não sabe nada do meu código base, não gera nada no meu estilo e alucina nas APIs Gradle Kotlin DSL.
OpenAI — GPT
| Modelo | $/M | Sortie \$/M | Custo/mês | × minha assinatura |
|---|---|---|---|---|
GPT 5.5 |
\$5 |
\$30 |
\$1 157 |
58× |
GPT 5.4 |
\$2,50 |
\$15 |
\$579 |
29× |
GPT 5.4 Mini |
\$0,75 |
\$4,50 |
\$174 |
9× |
Google — Gemini
| Modelo | $/M | Saída \$/M | Custo/mês | minha assinatura |
|---|---|---|---|---|
Gemini 3.1 Pro |
\$2,00 |
\$10 |
\$459 |
23× |
Gemini 3 Flash |
\$0,30 |
\$1,50 |
\$69 |
3,5× |
Gemini 3 Flash a 69€ é o único concorrente « próximo » em preço puro — mas é um modelo denso leve, não um MoE 1.6T como o DeepSeek V4 Pro. A qualidade do código gerado não tem nada a ver.
Provedores de Inferência HuggingFace
HuggingFace não realiza inferência por conta própria — ele agrega fornecedores terceiros (Novita, Together, DeepInfra, Cerebras, SambaNova, Fireworks, Groq…) via uma API unificada. Escolhe-se o fornecedor mais barato ou o mais rápido. Os tarifos coletados em maio de 2026 para DeepSeek V4 Pro são os seguintes:
| Provedor HF | $/M | Preservar TODO os spans de código entre crases (…) exatamente como estão — nunca modifique o conteúdo, o espaçamento ou a posição das crases. Este texto pode ser um fragmento de uma frase maior — traduza o fragmento sem solicitar mais contexto. Apresente apenas o texto traduzido — sem explicação, sem comentário, sem introdução, sem alternativas, sem opções. Saída \$/M |
Custo/mês | × minha assinatura |
|---|---|---|---|---|
Novita (o mais barato) |
\$1,67 |
\$3,38 |
$374 |
19× |
DeepInfra |
\$1,74 |
\$3,48 |
$389 |
19× |
junto |
\$2,10 |
\$4,40 |
$470 |
23× |
Fogos de artifício |
tarifa não pública |
— |
(Empty) |
— |
Mesmo o provedor mais barato na HuggingFace (Novita) cobra 19× o preço da minha assinatura. E, ao contrário do Ollama Cloud, a HuggingFace também cobra em mais as tarifas de plataforma se você não tiver uma assinatura PRO HF ($9/mês).
Groq
Groq não tem nenhum dos modelos que eu uso — o catálogo deles se limita a GPT-OSS, Llama e Qwen 32B. Impossível de comparar.
Comparativo Tarifário — Fornecedores Chineses
O verdadeiro teste é o mercado chinês. Se o DeepSeek é um modelo chinês, a sua API nativa deveria ser mais barata, não é?
DeepSeek API Direct (platform.deepseek.com)
| Período | $/M | Saída \$/M | Custo/mês |
|---|---|---|---|
Promo -75% (fim 31 de maio) |
\$0,435 |
\$0,87 |
$98 |
Tarifa cheia (a partir de junho) |
\$1,74 |
\$3,48 |
\$390 |
Mesmo com a promo agressiva da DeepSeek (-75% prolongada), a API direta custa5 vezesmais caro. À tarifa normal,20×. E isso é apenas DeepSeek — sem acesso a outros modelos.
Kimi Moonshot (platform.kimi.com)
Kimi apenas oferece seus próprios modelos. Sem DeepSeek.
Alibaba Bailian (bailian.aliyun.com)
Somente fornecedor que agrega todos os modelos chineses — mas por meio de revenda com margem. Os preços são carregados dinamicamente em JavaScript, tornando o scraping impossível.
Tabela Resumo — Todos Providers
| Fornecedor | Modelo | $/M | Saída \$/M | Custo/mês | × minha assinatura |
|---|---|---|---|---|---|
Ollama Nuvem Pro |
DeepSeek V4 Pro |
0 |
0 |
~20€ |
1× |
Gemini 3 Flash |
Gemini 3 Flash |
\$0,30 |
\$1,50 |
\$69 |
3,5× |
API DeepSeek (promo) |
DeepSeek V4 Pro |
\$0,44 |
\$0,87 |
\$98 |
5× |
GPT 5.4 Mini |
GPT 5.4 Mini |
\$0,75 |
\$4,50 |
\$174 |
9× |
Claude Haiku 4.5 |
Claude Haiku 4.5 |
\$1 |
\$5 |
\$230 |
11× |
HuggingFace/Novita |
DeepSeek V4 Pro |
\$1,67 |
\$3,38 |
\$374 |
19× |
DeepSeek API (normal) |
DeepSeek V4 Pro |
\$1,74 |
\$3,48 |
\$390 |
20× |
Together AI |
DeepSeek V4 Pro |
\$2,10 |
\$4,40 |
\$470 |
23× |
GPT 5.4 |
GPT 5.4 |
\$2,50 |
\$15 |
\$579 |
29× |
Claude Sonnet 4.6 |
Claude Sonnet 4.6 |
\$3 |
\$15 |
\$689 |
34× |
Claude Opus 4.7 |
Claude Opus 4.7 |
\$5 |
\$25 |
\$1 148 |
57× |
GPT 5.5 |
GPT 5.5 |
\$5 |
\$30 |
\$1 157 |
58× |
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 7) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 11

title Custo Mensal Projetado — 220M Input + 1,9M Output
rectangle "Ollama Cloud Pro
~20€" as OC #4CAF50
^^^^^
 Syntax Error? (Assumed diagram type: activity)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 11

title Custo Mensal Projetado — 220M Input + 1,9M Output
rectangle "Ollama Cloud Pro
~20€" as OC #4CAF50
rectangle "Gemini Flash
$69" as GF #8BC34A
rectangle "DeepSeek promoção
$98" as DSP #FFC107
rectangle "GPT Mini
$174" as GM #FF9800
rectangle "Claude Haiku
\$230" as CH #FF5722
rectangle "HF/Novita
\$374" as HF #F44336
rectangle "DeepSeek normal\n\$390" as DSN #F44336
rectangle "GPT 5.4
$579" as G4 #D32F2F
rectangle "Claude Sonnet
\$689" as CS #D32F2F
rectangle "Claude Opus
$1 148" as CO #B71C1C
rectangle "GPT 5.5
$1 157" as G5 #880E4F

note bottom of OC
  DeepSeek V4 Pro 1.6T MoE
  + accès à tout le catalogue
  Ollama Cloud (Qwen, GLM, Kimi...)
  Inclus dans l'abonnement
end note
@enduml
O Custo Oculto : Engenharia de Prompts e Iterações
O custo do token é apenas uma parte da equação. O verdadeiro custo é o tempo do desenvolvedor.
Com o OpenCode + Ollama Cloud Pro + meu agente de governança (EAGER/LAZY/Hot/Warm/Cold, descrito em o artigo sobre governança), obtenho:
-
0 prompt engineering repetitivo: o contexto é injetado automaticamente
-
90%+ de acerto na primeira tentativa: o código compila de primeira
-
Zero alucinação deepseek em 8 sessões consecutivas(documentado em la comparaison Kimi/GLM/DeepSeek)
Com Claude ou GPT sem ajuste fino nem governança:
-
2-3 iterações por tarefa em média
-
Prompt engineering sistemática
-
Alucinações nas APIs Kotlin/Gradle assim que o contexto ultrapassar 30K tokens
O custo « efetivo » mensal — tokens × iterações × tempo de correção — é de 27× a 54× o da minha solução, como eu demonstrei no artigo sobre a relação de eficiência.
_ Não é apenas uma questão de preço por token. Um Claude Opus a 57× o preço que requer 3× mais iterações, resultando em um custo efetivo ~170× maior. Para falar francamente: pagar a um estagiário o salário de um parceiro da McKinsey. _
Acumular as Assinaturas Ollama Cloud Pro: O Método Docker
Se uma única assinatura não for suficiente, acumulamos‑nas. O princípio é isolar cada assinatura em sua própria instalação Ollama, com sua própria chave SSH de autenticação. Docker torna isso trivial.
O método completo está detalhado em o artigo sobre o cumul Docker, aqui está o princípio :
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 9) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Arquitetura — Duas Assinaturas Ollama Cloud Pro em Uma Máquina
left to right direction

node "Minha Máquina Física" {
  frame "Ollama Instância A (nativo)
^^^^^
 Syntax Error? (Assumed diagram type: class)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Arquitetura — Duas Assinaturas Ollama Cloud Pro em Uma Máquina
left to right direction

node "Minha Máquina Física" {
  frame "Ollama Instância A (nativo)
porta :11434
Ollama Instância A (nativo)
porta :11434" as Native {
    database "Identidade A
/usr/share/ollama/.ollama/id_ed25519"
  }
  frame "Ollama Instance B (Docker)
porta :11435" as Docker {
    database "Identidade B
~/ollama-b-data/id_ed25519"
  }
}

cloud "Ollama Nuvem" {
  actor "Conta Pro A
(e‑mail 1)" as A
  actor "Conta Pro B\n(email 2)" as B
}

Native --> A : "Chave de dispositivo A"
Docker --> B : "Chave de dispositivo B"

note bottom of Docker
  Conteneur Docker isolé :
  - Clé SSH distincte
  - Port réseau distinct (11435)
  - Volume persistant (~/ollama-b-data)
  - restart: always
end note
@enduml
O padrão é simples :
-
Criar um volume`~/ollama-b-data`
-
Iniciar um contêiner Docker`ollama/ollama:0.20.2`mapeado em`11435:11434`
-
Recuperar a chave SSH do contêiner → registrá‑la em ollama.com
-
fazer`ollama signin`com um segundo e-mail
-
Configurar OpenCode com dois providers (`ollama`em :11434,`ollama-b`em :11435)
Duas contas, um cartão azul, zero conflito.
O Que a Auditoria Não Mede
| Ponto cego | Impacto |
|---|---|
Qualidade do código produzido |
2,6 bilhões de tokens não dizem se o código compila. As minhas 8 sessões DeepSeek V4 Pro têm uma taxa de first-shot >90%. |
Ecossistema OpenCode |
O CLI é gratuito, mas o seu valor (agentes, sandboxes, histórico, caching de prompt) é imenso. Não está incluído no preço da assinatura — é uma ferramenta separada. |
Custo de oportunidade |
Passar 2h/dia depurando as alucinações de um modelo inferior custa mais caro do que 20€/mês. |
Tranquilidade de espírito |
Tarifa fixa = sem surpresa. Com o modelo de preço por token, um pico de atividade pode fazer muito mal. |
|
Os preços citados são os de maio de 2026. Daqui a seis meses, tudo terá baixado. Mas a relação de força estrutural — assinatura fixa vs pagamento por uso — permanecerá favorável à assinatura para os grandes consumidores. |
Conclusão: O Veredito dos Números
Depois de 73 dias, 1 022 sessões OpenCode e 2,6 bilhões de tokens:
| Métrica | veredicto |
|---|---|
Custo acumulado da API externa |
$0,22(quase nulo) |
Custo assinatura Ollama Cloud Pro |
~20€/mês |
Equivalente Claude Opus |
\$1 148/mês— 57 vezes mais caro |
Equivalente GPT 5.5 |
$1 157/mês— 58 vezes mais caro |
Equivalente HuggingFace/Novita |
$374/mês— 19× mais caro |
Equivalente direto da API DeepSeek |
\$390/mês— 20 vezes mais caro |
Equivalente mais barato (Gemini Flash) |
\$69/mês— 3,5× mais caro, modelo inferior |
Melhor oferta do mercado |
Ollama Cloud Pro por 20€/mês— invencível |
__ A 20€ por mês para acessar o DeepSeek V4 Pro (1.6T params, MoE, CSA+HCA, 1M contexto) via Ollama Cloud, tenho a melhor relação custo-benefício do mercado mundial. Mesmo os fornecedores chineses diretos são 5× a 20× mais caros. Mesmo o HuggingFace, com sua agregação de providers low-cost, é 19× mais caro. O mercado ocidental (Claude, GPT) está em 50-60× — outro planeta.
Esta razão é tão desequilibrada que não pode durar para sempre. Aproveite enquanto isso existir. __
Então sim, meus 20 reais por mês, é o melhor investimento técnico da minha vida de desenvolvedor. E agora você tem os números para provar isso.
Referências
-
Artigo 0119 — Benchmark DGX Spark vs Cloud vs Assinaturas LLM
-
Article 0120 — Cumuler Deux Abonnements Ollama Cloud Pro avec Docker
-
Artigo 0121 — Plugin Gradle para Pilotar Duas Instâncias Ollama