Audit meines LLM-Verbrauchs: SQLite, OpenCode, Ollama Cloud und warum mein Pro-Abonnement den globalen Markt sprengt
Publié le 18 May 2026
- Den Stack verstehen: Wer macht was?
- Einleitung: Warum ein Audit?
- Die OpenCode-Datenbank: Eine Goldmine
- Die Ergebnisse: 73 Tage des Verbrauchs
- Tarifvergleich — Westliche Anbieter
- Preisvergleich — Chinesische Lieferanten
- Zusammenfassungstabelle — Alle Provider
- Der verborgene Kostenfaktor: Prompt-Engineering und Iterationen
- Ollama Cloud Pro Abonnements kumulieren: Die Docker-Methode
- Was das Audit nicht misst
- Fazit: Das Urteil der Zahlen
- Referenzen
Man fragt mich oft, wie viel mein KI‑Verbrauch kostet. Ich antworte: „20 Euro pro Monat“, und man schaut mich mit runden Augen an. Heute öffne ich deshalb die schwarze Box. Dieser Artikel ist die vollständige Prüfung meiner 73 Tage des Vibe‑Codings: die Methodik zur Extraktion der Daten aus der SQLite‑Datenbank von OpenCode, der SQL‑Code zum Abfragen der Tabellen und der umfassende Vergleich mit allen Marktteilnehmern — westlich wie chinesisch. Das Ergebnis ist so asymmetrisch, dass ich meine Berechnungen dreimal überprüfen musste.
- Zwangsstörung
-
[]
Den Stack verstehen: Wer macht was?
Bevor wir in die Zahlen eintauchen, klären wir die Architektur. Es gibt drei unterschiedliche Akteure in meinem Setup, und es ist wichtig, sie nicht zu verwechseln:
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 10) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Die drei Akteure meines LLM-Stacks
left to right direction

actor "Ich (Entwickler)" as Dev

package "OpenCode
^^^^^
 Syntax Error? (Assumed diagram type: component)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Die drei Akteure meines LLM-Stacks
left to right direction

actor "Ich (Entwickler)" as Dev

package "OpenCode
(github.com/anomalyco/opencode)" as OC {
  rectangle "CLI von vibe coding
Open Source, kostenlos" as CLI
  note right of CLI
    C'est l'outil que j'utilise
    pour coder avec des agents IA.
    Il ne fournit AUCUN modèle.
    C'est un terminal + un orchestrateur.
  end note
}

package "Ollama (Lokale Installation)" as OL {
  rectangle "Inferenzclient
Auf meinem Rechner installiert" as Client
  note right of Client
    C'est le logiciel qui fait tourner
    les modèles. Il peut les exécuter
    en local OU les déléguer au cloud
    selon le tag (:cloud).
    Il s'authentifie via clé SSH.
  end note
}

package "Ollama Cloud\n(ollama.com)" as OCloud {
  rectangle "Cloud-Inferenz-Dienst
Pro-Abonnement: 20€/Monat" as Cloud
  note right of Cloud
    C'est le fournisseur d'inférence.
    Mes modèles avec le tag :cloud
    sont exécutés sur LEURS serveurs.
    L'abonnement Pro donne accès
    à des quotas supérieurs.
  end note
}

Dev --> CLI : "Ich tippe Prompts"
CLI --> Client : "Rufe dieses Modell"
Client --> Cloud : "SSH-Schlüssel + Anfrage
(Modelle :cloud)"
Client --> Client : "Lokale Ausführung
(Modelle ohne :cloud)"

@enduml
|
OpenCode ist KEIN Anbieter von Modellen.Das ist eine Open-Source-CLI (github.com/anomalyco/opencode) der orchestriert KI-Agenten. Er verkauft kein Abonnement, er bietet keine Inferenz. Das ist das Äquivalent von`git`für die Versionierung: ein Werkzeug, kein Dienst. Ollama Cloud ist der Anbieter von Inferenz.Meine lokale Ollama-Installation agiert als Client — sie authentifiziert sich bei den Ollama-Servern mittels eines einzigartigen SSH-Schlüssels (Device Key) und delegiert ihr die Ausführung der mit Tags versehenen Modelle`:cloud`. Das Pro-Abonnement (20 €/Monat) ermöglicht höhere Kontingente und erlaubt das Kombinieren mehrerer Konten auf derselben Maschine über Docker. |
Einleitung: Warum ein Audit?
Vor zwei Monaten nutzte ich Modelle kostenlos auf meiner lokalen Ollama-Installation. Dann habe ich ein erstes Abonnement für Ollama Cloud Pro zu 20€/Monat abgeschlossen, das mir erlaubt, die Cloud-Modelle zu nutzen (diejenigen mit dem Tag`:cloud`) über den Provider`ollama-cloud`. Ein zweites Abonnement folgte einem Monat später auf einer getrennten Docker‑Instanz mit eigenem Konto und eigenem SSH‑Schlüssel — die im mon article sur le cumul d’abonnements beschriebene Methode des Kumulierens.
Die Frage, die mich beschäftigte: sind diese 20 € pro Monat gerechtfertigt? Nicht aus dem Bauchgefühl. Mit Zahlen.
Um zu antworten, brauchte ich präzise Daten. Keine Schätzungen. Keine Durchschnittswerte. Mein tatsächlicher Verbrauch, Token für Token, Modell für Modell, Sitzung für Sitzung.
Und OpenCode — die CLI — speichert das alles in einer SQLite-Datenbank.
Die OpenCode-Datenbank: Eine Goldmine
OpenCode speichert den vollständigen Verlauf seiner Sitzungen in einer SQLite-Datei, die sich befindet an`~/.local/share/opencode/opencode.db`. La mienne pèse 660 Mo pour 73 jours d’utilisation — une base de données de production tout à fait respectable.
$ ls -lh ~/.local/share/opencode/opencode.db
-rw-r--r-- 1 cheroliv cheroliv 660M mai 18 12:25 opencode.db
Das Schema
Die Basis enthält etwa zwanzig Tabellen, doch drei davon sind für unser Audit entscheidend:
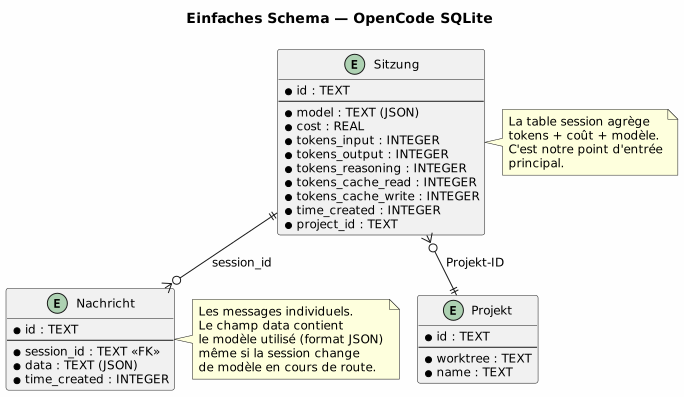
Der Tisch`session`ist perfekt für eine globale Prüfung: jede Sitzung hat ihre aggregierte Token-Zahl, das verwendete Modell und ihre Kosten. Das Feld`model`ist rohes JSON :
{
  "id": "deepseek-v4-pro:cloud",
  "providerID": "ollama-cloud",
  "variant": "default"
}|
Das Feld`cost`In der OpenCode-Datenbank werden nur die externen API-Gebühren widergespiegelt, die nach Verbrauch über den API-Schlüssel (Google Gemini, OpenAI usw.) gezahlt werden. Aufrufe über Ollama – ob lokal oder über Ollama Cloud Pro – werden gekennzeichnet.`cost=0`Weil der Kostenbetrag pauschal (Abonnement) ist, nicht pro Token. Der eigentliche Kostenfaktor dieser Anrufe ist das monatliche Abonnement. |
Der Extraktionscode
Es muss nichts installiert werden. Node.js 22+ enthält ein experimentelles SQLite‑Modul.node:sqlite) funktioniert einwandfrei. Hier ist das Skript, das mir alles gegeben hat :
const { DatabaseSync } = require('node:sqlite');
const db = new DatabaseSync(
  `${process.env.HOME}/.local/share/opencode/opencode.db`,
  { readonly: true }
);

// 1. Statistiques globales
const global = db.prepare(`
  SELECT
    COUNT(*) as sessions,
    SUM(tokens_input) as total_input,
    SUM(tokens_output) as total_output,
    SUM(tokens_reasoning) as total_reasoning,
    SUM(tokens_cache_read) as total_cache_read,
    SUM(cost) as total_cost
  FROM session
`).get();

// 2. Ventilation par modèle et fournisseur
const byModel = db.prepare(`
  SELECT
    json_extract(model, '$.id') as model_id,
    json_extract(model, '$.providerID') as provider,
    COUNT(*) as sessions,
    SUM(tokens_input) as total_input,
    SUM(tokens_output) as total_output,
    SUM(cost) as total_cost
  FROM session
  WHERE model IS NOT NULL
  GROUP BY model_id, provider
  ORDER BY SUM(tokens_input) DESC
`).all();

// 3. Par mois
const monthly = db.prepare(`
  SELECT
    strftime('%Y-%m', datetime(time_created/1000, 'unixepoch')) as month,
    COUNT(*) as sessions,
    SUM(tokens_input) as total_input,
    SUM(tokens_output) as total_output,
    SUM(cost) as total_cost
  FROM session
  WHERE time_created IS NOT NULL
  GROUP BY month
  ORDER BY month
`).all();

// 4. Messages par modèle (détection des changements intra-session)
const msgByModel = db.prepare(`
  SELECT
    json_extract(m.data, '$.model.providerID') as provider,
    json_extract(m.data, '$.model.modelID') as model_id,
    COUNT(*) as messages
  FROM message m
  WHERE json_extract(m.data, '$.model') IS NOT NULL
  GROUP BY provider, model_id
  ORDER BY COUNT(*) DESC
`).all();

console.log({ global, byModel, monthly, msgByModel });
db.close();|
Das Flag`--experimental-sqlite`ist auf Node.js 22.x erforderlich. Auf Node.js 24+ ist das Modul stabil und erfordert keinen Flag mehr. |
Die Ergebnisse: 73 Tage des Verbrauchs
Globale Ansicht
| Metrisch | Wert | Kontext |
|---|---|---|
Sessions OpenCode |
1 022 |
~14 Sitzungen/Tag im Durchschnitt |
Tokens Eingabe |
2,62 Milliarden |
Darunter 94,5 M Cache-Hits |
Tokens Output |
21 Millionen |
Ratio input/output ~125:1 |
Tokens Reasoning |
141 000 |
vernachlässigbar — kein Denken |
Kosten der externen API |
\$0,22 |
Gebühren außerhalb des Abonnements (Gemini + free tiers) |
Dieser Betrag von \$0,22 ist entscheidend: Er repräsentiert alles, was ich zusätzlich zu meinem Ollama Cloud Pro-Abonnement bezahlt habe. Das ist praktisch nichts. Das Abonnement deckt das Wesentliche ab.
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 7) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Monatliche Entwicklung — Tokeneingabe
rectangle "März 2026
9 Sitzungen
^^^^^
 Syntax Error? (Assumed diagram type: activity)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Monatliche Entwicklung — Tokeneingabe
rectangle "März 2026
9 Sitzungen
37,7M Tokens" as MARS #FFE082
rectangle "April 2026
486 Sitzungen
1,33 Mrd Token" as AVR #81C784
rectangle "Mai 2026
527 Sitzungen
1,25 Mrd Tokens" as MAI #64B5F6

MARS -right-> AVR : ×35
AVR -right-> MAI : stable (période en cours)

note bottom of MAI
  Mai comptabilisé jusqu'au 18.
  Projection mois complet : ~2,1 Md tokens
  si la tendance se maintient.
end note
@enduml
Der Abflug zwischen März und April ist spektakulär: ×35 in einem Monat. Es ist der Übergang von der Nutzung „test“ zur Nutzung „produktion“ — als ich begonnen habe, OpenCode-Agenten kontinuierlich für meine Gradle-Plugins laufen zu lassen.
Ventilierung von Modell und Lieferant
Das Feld`model`des Tisches`session`seiend JSON,`json_extract()`ermöglicht eine saubere Belüftung:
| Modell × Anbieter | Sitzungen | (empty) | Output | Kosten |
|---|---|---|---|---|
deepseek-v4-pro @ ollama-cloud |
63 |
220 M |
1,94 M |
\$0 |
deepseek-v4-pro @ ollama-b |
124 |
463 M |
4,15 M |
\$0 |
deepseek-v4-pro @ ollama |
100 |
252 M |
2,25 M |
\$0 |
deepseek-v4-flash-free @ opencode |
16 |
1,3 M |
279 K |
\$0 |
qwen3.6-plus-free @ opencode |
1 |
369 K |
25 K |
\$0 |
gemini-2.5-flash @ google |
1 |
211 K |
19 K |
\$0,04 |
|
Drei verschiedene Provider für genau das gleiche Modell DeepSeek V4 Pro:
* |
Die Intrasession-Modelle: Was die Sitzungstabelle nicht sieht
Der Tisch`session`Erfasst nur das haupt Modell der Session. Aber während derselben Sitzung kann ein OpenCode-Agent zwischen mehreren Modellen wechseln. Die Tabelle`message`er enthüllt :
Modèles utilisés dans les messages (ollama-cloud provider) :
├─ deepseek-v4-pro      1 441 msgs  (32%)
├─ qwen3.5:397b         1 217 msgs  (27%)
├─ glm-5.1                712 msgs  (16%)
├─ kimi-k2.6:cloud        634 msgs  (14%)
├─ qwen3-coder:480b       414 msgs   (9%)
├─ gpt-oss:20b             34 msgs  (0,8%)
├─ qwen3-coder-next        27 msgs  (0,6%)
└─ gemma4:31b 7 msgs (0,2%)|
Ich benutze Qwen, GLM, Kimi und die anderen Modelle nicht mehr. Sie erscheinen im Verlauf, weil ich im April einiges getestet habe. Seit Mitte Mai bin ich auf DeepSeek V4 Pro festgelegt — es ist das einzige, das die Belastung bei langen Kontexten mit Agenten-Governance hält (vgl. mein Vergleich Kimi/GLM/DeepSeek). Die 32% DeepSeek-Nachrichten im Verlauf sind irreführend: heute sind es 100%. |
Tarifvergleich — Westliche Anbieter
Die unbequeme Frage: Wie viel würde derselbe Verbrauch bei traditionellen Anbietern kosten?
Meine Berechnungsgrundlage für den Vergleich :220M Tokens Eingabe + 1,9M Tokens Ausgabe— nur das weitergegebene Volumen`ollama-cloud`(der einzige, der zu meinem kostenpflichtigen Abonnement passt). Die restlichen 716M sind kostenlos (lokale Ollama-Instanz und Docker-B-Instanz).
| Lieferant | Modell | \$/M | Ausgabe \$/M | Kosten pro Monat | Mein Abonnement |
|---|---|---|---|---|---|
Mein Setup |
DeepSeek V4 Pro |
0 |
0 |
\~20€ |
1× |
Anthropic — Claude
| Modell | \$/M | Output $/M | Kosten/Monat | × mein Abonnement |
|---|---|---|---|---|
Opus 4.7 |
\$5 |
\$25 |
\$1 148 |
57× |
Sonnet 4.6 |
\$3 |
\$15 |
\$689 |
34× |
Haiku 4.5 |
\$1 |
\$5 |
\$230 |
11× |
Sogar Haiku 4.5, das kostengünstigste Modell von Claude, kostet das 11-fache meines Abonnements. Und es kennt nichts von meiner Codebasis, generiert nicht in meinem Stil, und halluciniert über die Gradle-Kotlin-DSL-APIs.
OpenAI — GPT
| Modell | $/M | Ausgabe \$/M | Kosten/Monat | × mein Abonnement |
|---|---|---|---|---|
GPT 5.5 |
\$5 |
\$30 |
\$1 157 |
58× |
GPT 5.4 |
\$2,50 |
\$15 |
\$579 |
29× |
GPT 5.4 Mini |
\$0,75 |
\$4,50 |
\$174 |
9× |
Google — Gemini
| Modell | $/M | Ausgabe $/M | Kosten/Monat | × mein Abonnement |
|---|---|---|---|---|
Gemini 3.1 Pro |
\$2,00 |
\$10 |
\$459 |
23× |
Gemini 3 Flash |
\$0,30 |
\$1,50 |
\$69 |
3,5× |
Gemini 3 Flash zu 69 € ist der einzige Konkurrent „nah“ im reinen Preis — aber es ist ein dichtes, leichtes Modell, kein MoE 1,6T wie DeepSeek V4 Pro. Die Qualität des generierten Codes hat nichts damit zu tun.
HuggingFace Inferenzanbieter
HuggingFace führt keine Inferenz selbst durch — es agregiert providers von Drittanbietern (Novita, Together, DeepInfra, Cerebras, SambaNova, Fireworks, Groq…) über eine einheitliche API. Man wählt den günstigsten oder schnellsten provider. Hier sind die im Mai 2026 ermittelten Tarife für DeepSeek V4 Pro :
| Anbieter HF | \$/M | Output \$/M | Kosten/Monat | Mein Abonnement |
|---|---|---|---|---|
Novita (am günstigsten) |
\$1,67 |
\$3,38 |
\$374 |
19× |
DeepInfra |
\$1,74 |
\$3,48 |
\$389 |
19× |
Gemeinsam |
\$2,10 |
\$4,40 |
$470 |
23× |
Feuerwerk |
nicht öffentlicher Tarif |
— |
— |
— |
Selbst der günstigste Provider auf HuggingFace (Novita) berechnet 19× den Preis meines Abonnements. Und im Gegensatz zu Ollama Cloud berechnet HuggingFace zusätzlich die Plattformgebühren, wenn du kein PRO-HF-Abonnement hast (\$9/Monat).
Groq
Groq hat keine der Modelle, die ich verwende — ihr Katalog beschränkt sich auf GPT-OSS, Llama und Qwen 32B. Ein Vergleich ist unmöglich.
Preisvergleich — Chinesische Lieferanten
Der wahre Test ist der chinesische Markt. Wenn DeepSeek ein chinesisches Modell ist, sollte seine native API günstiger sein, oder?
DeepSeek API direct (platform.deepseek.com)
| Periode | $/M | Ausgabe $/M | Kosten/Monat |
|---|---|---|---|
Angebot -75% (Ende 31. Mai) |
\$0,435 |
\$0,87 |
\$98 |
Volltarif (ab Juni) |
\$1,74 |
\$3,48 |
\$390 |
Selbst mit der aggressiven Promotion von DeepSeek (-75% verlängert), kostet die direkte API5 malteurer. Zum Normaltarif,20×. Und das ist nur DeepSeek — kein Zugriff auf andere Modelle.
Kimi Moonshot (platform.kimi.com)
Kimi bietet nur seine eigenen Modelle an. Kein DeepSeek.
Alibaba Bailian (bailian.aliyun.com)
Einziger Anbieter, der alle chinesischen Modelle aggregiert — jedoch durch Weiterverkauf mit Aufschlag. Die Preise werden dynamisch über JavaScript geladen, wodurch das Scraping unmöglich ist.
Zusammenfassungstabelle — Alle Provider
| Lieferant | Modell | $\$/M$ | Ausgabe \$/M | Kosten/Monat | × mein Abonnement |
|---|---|---|---|---|---|
Ollama Cloud Pro |
DeepSeek V4 Pro |
0 |
0 |
ungefähr 20 € |
1× |
Gemini 3 Blitz |
Gemini 3 Blitz |
\$0,30 |
\$1,50 |
\$69 |
3,5× |
DeepSeek API (promo) |
DeepSeek V4 Pro |
\$0,44 |
\$0,87 |
\$98 |
5× |
GPT 5.4 Mini |
GPT 5.4 Mini |
\$0,75 |
\$4,50 |
\$174 |
9× |
Claude Haiku 4.5 |
Claude Haiku 4.5 |
\$1 |
\$5 |
\$230 |
11× |
HuggingFace/Novita |
DeepSeek V4 Pro |
\$1,67 |
\$3,38 |
\$374 |
19× |
DeepSeek API (normal) |
DeepSeek V4 Pro |
\$1,74 |
\$3,48 |
\$390 |
20× |
Gemeinsam KI |
DeepSeek V4 Pro |
\$2,10 |
\$4,40 |
\$470 |
23× |
GPT 5.4 |
GPT 5.4 |
\$2,50 |
\$15 |
\$579 |
29× |
Claude Sonnet 4.6 |
Claude Sonnet 4.6 |
\$3 |
\$15 |
\$689 |
34× |
Claude Opus 4.7 |
Claude Opus 4.7 |
\$5 |
\$25 |
\$1 148 |
57× |
GPT 5.5 |
GPT 5.5 |
\$5 |
\$30 |
\$1 157 |
58× |
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 8) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 11

title Projizierte monatliche Kosten — 220M Eingabe + 1,9M Ausgabe
rectangle "Ollama Cloud Pro\n~20€" as OC #4CAF50
rectangle "Gemini Flash
$69" as GF #8BC34A
^^^^^
 Syntax Error? (Assumed diagram type: activity)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 11

title Projizierte monatliche Kosten — 220M Eingabe + 1,9M Ausgabe
rectangle "Ollama Cloud Pro\n~20€" as OC #4CAF50
rectangle "Gemini Flash
$69" as GF #8BC34A
rectangle "DeepSeek-Promo
\$98" as DSP #FFC107
rectangle "GPT Mini
$174" as GM #FF9800
rectangle "Claude Haiku\n\$230" as CH #FF5722
rectangle "HF/Novita\n\$374" as HF #F44336
rectangle "DeepSeek normal
\$390" as DSN #F44336
rectangle "GPT 5.4\n\$579" as G4 #D32F2F
rectangle "Claude Sonnet
\$689" as CS #D32F2F
rectangle "Claude Opus
$1 148" as CO #B71C1C
rectangle "GPT 5.5\n\$1 157" as G5 #880E4F

note bottom of OC
  DeepSeek V4 Pro 1.6T MoE
  + accès à tout le catalogue
  Ollama Cloud (Qwen, GLM, Kimi...)
  Inclus dans l'abonnement
end note
@enduml
Der verborgene Kostenfaktor: Prompt-Engineering und Iterationen
Die Token-Kosten sind nur ein Teil der Gleichung. Der wirkliche Kostenfaktor ist die Entwicklerzeit.
Mit OpenCode + Ollama Cloud Pro + mein Governance-Agent (EAGER/LAZY/Hot/Warm/Cold, beschrieben in der Artikel über die Governance), erhalte ich:
-
0 wiederholtes Prompt-EngineeringDer Kontext wird automatisch injiziert
-
90%+ erster Schuss richtig: der Code kompiliert beim ersten Versuch
-
Null hallucination deepseek über 8 aufeinanderfolgende Sitzungen(dokumentiert in der Vergleich Kimi/GLM/DeepSeek)
Mit Claude oder GPT ohne Feintuning und Governance :
-
2-3 Iterationen pro Aufgabe im Durchschnitt
-
systematisches Prompt-Engineering
-
Halluzinationen bei den Kotlin/Gradle-APIs, sobald der Kontext mehr als 30K Tokens überschreitet
Der »effektive« Kosten pro Monat — Tokens × Iterationen × Korrekturzeit — beträgt das 27‑ bis 54‑fache meiner Lösung, wie ich in dem Artikel über das Effizienzverhältnis gezeigt habe.
_ Es geht nicht nur um den Preis pro Token. Ein Claude Opus zum 57× Preis, der 3× mehr Iterationen erfordert, hat effektiv Kosten von ~170× höher. Ausgedrückt deutlich: Einen Praktikanten zu bezahlen wie einen McKinsey‑Partner. </think> _
Ollama Cloud Pro Abonnements kumulieren: Die Docker-Methode
Wenn ein einzelnes Abonnement nicht ausreicht, kombinieren wir sie. Das Prinzip besteht darin, jedes Abonnement in seiner eigenen Ollama-Installation zu isolieren, mit seinem eigenen SSH-Authentifizierungsschlüssel. Docker macht das trivial.
Die vollständige Methode wird in der Artikel über das Kombinieren von Docker beschrieben, hier das Prinzip:
Failed to generate image: PlantUML preprocessing failed: [From <input> (line 9) ]

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Architektur — Zwei Ollama Cloud Pro‑Abonnements auf einer Maschine
left to right direction

node "Meine physische Maschine" {
  frame "Ollama Instanz A (einheimisch)
^^^^^
 Syntax Error? (Assumed diagram type: class)

@startuml
skinparam backgroundColor #FEFEFE
skinparam defaultFontSize 12

title Architektur — Zwei Ollama Cloud Pro‑Abonnements auf einer Maschine
left to right direction

node "Meine physische Maschine" {
  frame "Ollama Instanz A (einheimisch)
Port :11434" as Native {
    database "Identität A\n/usr/share/ollama/.ollama/id_ed25519"
  }
  frame "Ollama-Instanz B (Docker)
Port :11435" as Docker {
    database "Identität B\n~/ollama-b-data/id_ed25519"
  }
}

cloud "Ollama Cloud" {
  actor "Konto Pro A\n(E‑Mail 1)" as A
  actor "Geschäftskonto B\n(E-Mail 2)" as B
}

Native --> A : "Gerätenschlüssel A"
Docker --> B : "Geräteschlüssel B"

note bottom of Docker
  Conteneur Docker isolé :
  - Clé SSH distincte
  - Port réseau distinct (11435)
  - Volume persistant (~/ollama-b-data)
  - restart: always
end note
@enduml
Das Muster ist einfach:
-
Ein Volume erstellen`~/ollama-b-data`
-
Einen Docker-Container starten`ollama/ollama:0.20.2`aufgemappt`11435:11434`
-
SSH-Schlüssel des Containers abrufen → auf ollama.com speichern
-
tun`ollama signin`mit einer zweiten E‑Mail
-
OpenCode mit zwei Providern konfigurieren (`ollama`auf :11434,`ollama-b`auf :11435)
Zwei Konten, eine blaue Karte, kein Konflikt.
Was das Audit nicht misst
| Toter Winkel | Auswirkung |
|---|---|
Qualität des produzierten Codes |
2,6 Milliarden Token sagen nicht aus, ob der Code kompiliert. Meine 8 Sessions DeepSeek V4 Pro haben eine First-Shot-Rate >90%. |
Ökosystem OpenCode |
Der CLI ist kostenlos, aber sein Wert (Agenten, Sandboxes, Verlauf, Prompt-Caching) ist immens. Er ist nicht im Abonnementspreis enthalten — es ist ein separates Werkzeug. |
Opportunitätskosten |
2 Stunden pro Tag damit zu verbringen, Halluzinationen eines minderwertigen Modells zu debuggen, kostet mehr als 20 € pro Monat. |
Ruhe des Geistes |
Festpreis = keine Überraschung. Beim Preismodell pro Token kann ein Aktivitätsschub sehr schmerzhaft sein. |
|
Die genannten Preise sind die von Mai 2026. In sechs Monaten wird alles gesunken sein. Doch das strukturelle Machtverhältnis — Festabonnement gegenüber Nutzungsgebühr — wird für Vielverbraucher weiterhin zugunsten des Abonnements sein. |
Fazit: Das Urteil der Zahlen
Nach 73 Tagen, 1 022 OpenCode-Sessions und 2,6 Milliarden Tokens :
| Metrik | Urteil |
|---|---|
Kumulierte externe API‑Kosten |
\$0,22(nahezu null) |
Kosten des Ollama Cloud Pro-Abonnements |
~20€/Monat |
Claude Opus-Entsprechung |
$1 148/Monat— 57× teurer |
Entsprechung GPT 5.5 |
$1 157/Monat— 58× teurer |
Äquivalent HuggingFace/Novita |
$374/Monat— 19‑mal teurer |
Direktes DeepSeek API-Äquivalent |
\$390/Monat— 20‑mal teurer |
Günstigstes Äquivalent (Gemini Flash) |
\$69/Monat— 3,5× teurer, unteres Modell |
Bestes Angebot des Marktes |
Ollama Cloud Pro für 20 €/Monat— unbesiegbar |
(empty) Für 20 € pro Monat, um auf DeepSeek V4 Pro (1,6 T Parameter, MoE, CSA+HCA, 1 Mio Kontext) über Ollama Cloud zuzugreifen, habe ich das beste Preis‑Leistungs‑Verhältnis des globalen Marktes. Selbst chinesische Anbieter direkt sind 5‑ bis 20‑mal teurer. Selbst HuggingFace, mit seiner Aggregation von Low‑Cost‑Anbietern, ist 19‑mal teurer. Der westliche Markt (Claude, GPT) liegt bei 50‑60‑mal – ein anderer Planet.
Dieses Verhältnis ist so unausgewogen, dass es nicht ewig dauern kann. Nutze es, solange es besteht. __
Also ja, meine 20 Euro pro Monat ist die beste technische Investition meines Entwicklerlebens. Und jetzt habt ihr die Zahlen, um das zu beweisen.
Referenzen
-
Artikel 0119 — Benchmark DGX Spark vs Cloud vs LLM-Abonnements
-
Artikel 0120 — Zwei Ollama Cloud Pro-Abonnements mit Docker kombinieren
-
Artikel 0121 — Gradle-Plugin zur Steuerung von zwei Ollama-Instanzen